A geração de código curto se resume a quatro opções: codificar um contador único em base62, sortear caracteres aleatórios, truncar um hash da URL ou distribuir faixas de IDs a partir de um coordenador. Os contadores nunca colidem, mas são adivinháveis. Os códigos aleatórios não são adivinháveis, mas precisam de um caminho de nova tentativa. Hash e truncamento é a mais fraca das quatro, porque colide mais cedo do que as pessoas esperam e não oferece nada que as outras não ofereçam.
Os números decidem a maior parte, então este post os percorre. Um código base62 de 7 caracteres tem exatamente 3.521.614.606.208 valores, e um aleatório tem 50% de chance de pelo menos uma colisão depois de aproximadamente 2,2 milhões de links. O primeiro fato faz 7 caracteres parecerem enormes. O segundo é o limite do aniversário, e é por isso que "trilhões de possibilidades" não significa "nenhuma colisão".
Se você quer o sistema inteiro em torno do código (armazenamento, redirecionamentos, cache), comece por como construir um encurtador de URL. Este é o zoom em uma decisão desse passo a passo: de onde vem o código curto.
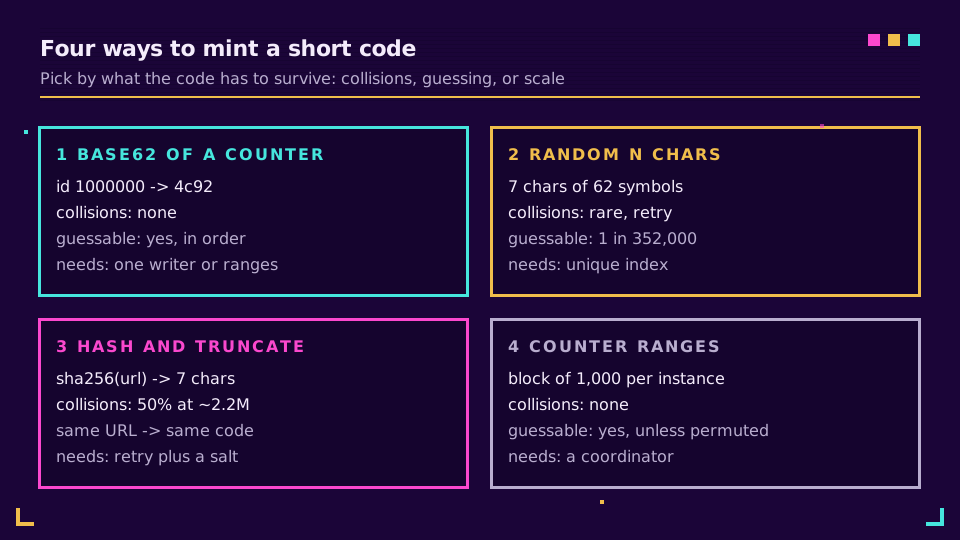
Codificação Base62 de um ID Auto-Incremental
A codificação base62 converte um número em uma string sobre os 62 símbolos 0-9, a-z, A-Z. É a mesma ideia do hexadecimal com um alfabeto maior, e é a forma de texto mais curta e segura para URL de um inteiro que evita pontuação. O ID 125 vira 21 (2 x 62 + 1), e 1,000,000 vira 4c92.
const ALPHABET =
  "0123456789abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ";

export function encode(id: bigint): string {
  if (id === 0n) return ALPHABET[0];
  let out = "";
  while (id > 0n) {
    out = ALPHABET[Number(id % 62n)] + out;
    id /= 62n;
  }
  return out;
}

export function decode(code: string): bigint {
  let id = 0n;
  for (const ch of code) id = id * 62n + BigInt(ALPHABET.indexOf(ch));
  return id;
}
A força é que a unicidade é herdada do banco de dados. A linha 41.000.000 recebe um código e ninguém mais jamais o recebe. Não há laço de nova tentativa nem consulta antes da inserção. Os códigos também crescem devagar: IDs abaixo de 62^6 geram códigos de seis caracteres ou menos, e o primeiro código de 7 caracteres aparece no ID 56.800.235.584.
A fraqueza é a exposição. O código é o número da linha disfarçado, então decode("4c92") retorna 1000000. Qualquer pessoa pode contar seus links, estimar seu crescimento a partir de duas amostras com uma semana de diferença e percorrer todos os códigos em ordem. Para uma ferramenta interna, tudo bem. Para um encurtador público, é uma API de extração gratuita, o que importa para os riscos de redirecionamento aberto e enumeração abordados em outro ponto deste blog.
Você pode esconder a ordem sem perder a unicidade passando o ID por uma permutação invertível (uma pequena rede de Feistel é a escolha usual) antes de codificar. Cuidado com atalhos. Multiplicar por uma constante módulo 62^7 parece embaralhado, mas mantém o último dígito incrementando, o que um teste rápido revela. Um contador embaralhado é ofuscação, não sigilo.
Códigos Aleatórios: Espaço de Chaves, Novas Tentativas e o Limite do Aniversário
Um código curto aleatório sorteia cada caractere de forma independente a partir do alfabeto. Use uma fonte criptográfica e uma escolha sem viés. randomInt(62) no Node faz amostragem por rejeição para você, enquanto byte % 62 distorce a distribuição porque 256 não é múltiplo de 62.
import { randomInt } from "node:crypto";

export function randomCode(length = 7): string {
  let out = "";
  for (let i = 0; i < length; i++) out += ALPHABET[randomInt(62)];
  return out;
}
Qual deve ser o comprimento do código? O espaço de chaves é 62^comprimento, e o problema do aniversário diz que, entre n sorteios aleatórios de N valores, a chance de pelo menos uma repetição é de cerca de 1 - e^(-n²/2N). Ela chega a 50% em aproximadamente sqrt(2N ln 2) sorteios. O problema do aniversário é contraintuitivo porque os pares crescem com o quadrado de n.
| Comprimento | Espaço de chaves (62^L) | Códigos aleatórios até 50% de chance de repetição | Chance de uma nova inserção colidir com 100M de links |
|---|---|---|---|
| 6 | 56.800.235.584 | cerca de 280.600 | 1 em 568 (0,18%) |
| 7 | 3.521.614.606.208 | cerca de 2.209.500 | 1 em 35.216 (0,0028%) |
| 8 | 218.340.105.584.896 | cerca de 17.397.800 | 1 em 2.183.401 (0,000046%) |
A última coluna é o número que importa operacionalmente. Uma repetição entre todos os seus links é quase certa em escala, mas o que o seu código realmente experimenta é uma única inserção encontrando um espaço ocupado, e essa chance é apenas links / espaço de chaves. Com 100 milhões de links e 7 caracteres, uma inserção em cerca de 35.000 colide. Você verá isso em produção, então precisa de um caminho de nova tentativa, mas ele é barato.
Tratamento de Colisões: Deixe o Banco de Dados Decidir
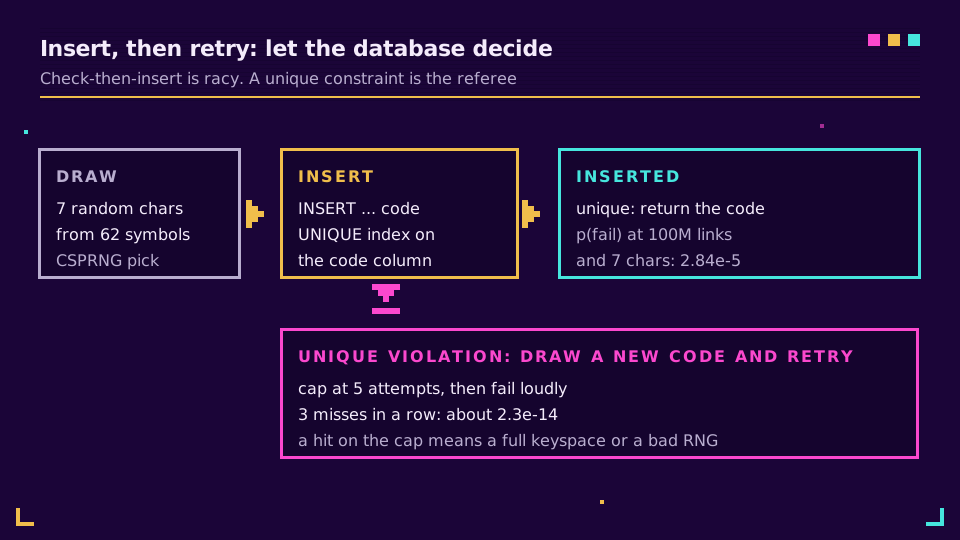
O padrão que funciona é inserir e tentar de novo, não verificar e depois inserir. Duas requisições podem ambas verificar que aB3x9Qz está livre e depois ambas gravá-lo. Uma restrição de unicidade na coluna do código fecha essa condição de corrida, e a inserção que falha é o seu sinal para sortear de novo.
export async function createWithRetry(
  tryInsert: (code: string) => Promise<boolean>, // false = unique violation
  attempts = 5,
): Promise<string> {
  for (let i = 0; i < attempts; i++) {
    const code = randomCode();
    if (await tryInsert(code)) return code;
  }
  throw new Error("could not allocate a short code");
}
Aqui tryInsert executa seu INSERT e retorna false apenas em um erro de violação de unicidade, nunca em outras falhas. Se uma única inserção colide com probabilidade p, todas as tentativas falham com probabilidade p^tentativas. No ponto de 100M de links e 7 caracteres, p é 2,84 x 10^-5, então três falhas seguidas dão cerca de 2,3 x 10^-14. Limite as tentativas de qualquer forma. Se você algum dia vir o limite atingido, o espaço de chaves está quase cheio ou a fonte aleatória está quebrada, e um erro alto vence um laço infinito.
A mesma disciplina se aplica à idempotência no endpoint de criação, porque uma requisição HTTP repetida não deve gerar um segundo link. Limites de taxa e idempotência cobre essa outra metade.
Hash e Truncamento: Por Que Colide Mais Cedo do Que Você Pensa
Fazer o hash da URL parece atraente porque é determinístico: a mesma URL sempre gera o mesmo código, então você pode pular uma consulta por duplicatas. O custo é que um código só tem uma certa quantidade de bits para gastar. Pegar 32 bits de um digest dá 2^32 = 4.294.967.296 valores, e o ponto de 50% de colisão é de cerca de 77.163 URLs. Não bilhões. Uma fatia base62 de 7 caracteres (cerca de 41,7 bits) leva isso a aproximadamente 2,2 milhões, o mesmo de um código aleatório de 7 caracteres.
import { createHash } from "node:crypto";

export function hashCode(url: string, length = 7): string {
  const digest = createHash("sha256").update(url).digest();
  const n = digest.readBigUInt64BE(0) % 62n ** BigInt(length);
  return encode(n).padStart(length, "0");
}
Então o truncamento não quebra o hash. O SHA-256 está bem. A resistência a colisões dos 256 bits completos simplesmente não sobrevive a ser cortada para 41 bits. Você herda o comportamento de um código aleatório, então ainda precisa do caminho de nova tentativa, além de uma regra para o que fazer em um choque (adicionar sal e refazer o hash). E o determinismo joga contra você: dois clientes que encurtam a mesma URL recebem o mesmo código e, portanto, o mesmo fluxo de cliques, a menos que você misture um ID de conta. Eu evitaria o hash e truncamento em quase todos os casos. Se você quer deduplicação, consulte a URL por uma coluna de hash e gere o código de outra forma.
Faixas de Contador e IDs no Estilo Snowflake
Uma única coluna auto-incremental vira um gargalo quando vários escritores em várias regiões precisam de IDs. Dois padrões evitam isso sem abrir mão da unicidade.
O primeiro são as faixas de contador. Um coordenador entrega a cada instância da aplicação um bloco, digamos 1.000 IDs, e a instância os codifica localmente, sem ida e volta por link. Se uma instância morre, seu bloco não usado é simplesmente pulado. Lacunas em um espaço de códigos de trilhões são inofensivas.
O segundo é um ID no estilo Snowflake: um carimbo de data e hora, um ID de máquina e uma sequência por milissegundo empacotados em 64 bits. Eles se ordenam por data de criação e não precisam de coordenador. O porém para links curtos é o comprimento. Um valor de 64 bits chega a 18.446.744.073.709.551.615, e como 62^10 = 839.299.365.868.340.224 é menor que 2^64, ele precisa de até 11 caracteres base62. Isso não é muito curto. Os IDs Snowflake se encaixam melhor em chaves de banco de dados do que em códigos públicos, então a maioria dos encurtadores os mantém internos e usa um código separado e mais curto.
Ambos herdam o problema de adivinhabilidade sequencial, porque ambos são ordenados por construção. Envolva-os em uma permutação, ou use um deles apenas como chave primária interna.
Códigos Personalizados e Palavras Reservadas
Os slugs personalizados são o único lugar em que um humano escolhe o código, e eles passam pela mesma restrição de unicidade que tudo o mais. O trabalho extra é a validação antes da inserção. Um back-half personalizado como /spring-sale precisa ser verificado contra três coisas.
- Palavras reservadas. Caminhos que sua aplicação ou a web já usam nunca devem poder ser reivindicados:
api,admin,login,static,robots.txt,favicon.icoe.well-known. Um encurtador que deixa alguém registrar/loginconstruiu um gerador de páginas de phishing. - Colisões com códigos gerados. Se um usuário toma
/aB3x9Qz, seu gerador aleatório pode mais tarde produzir a mesma string. A restrição de unicidade resolve, desde que códigos personalizados e gerados compartilhem um único espaço de nomes. - Maiúsculas e minúsculas e semelhantes visuais. O base62 diferencia maiúsculas de minúsculas, então
/Abe/absão links diferentes. Decida se os slugs personalizados são comparados sem diferenciar maiúsculas e minúsculas, e considere bloquear pares que diferem apenas por0/Ooul/1. O guia de URLs personalizadas cobre o lado da marca.
Códigos aleatórios de 7 caracteres também podem formar algo inconveniente. Passe os códigos gerados por uma lista de bloqueio curta e sorteie de novo em caso de correspondência. Custa quase nada.
Enumeração, Adivinhabilidade e Privacidade
Um código curto é um endereço. Não é um segredo, e nenhum comprimento o transforma em um. Ainda assim, a diferença entre sequencial e aleatório é grande. Com códigos sequenciais, cada palpite acerta um link ativo. Com 10 milhões de links distribuídos aleatoriamente por 62^7 valores, um palpite às cegas acerta um com probabilidade de 10.000.000 / 3.521.614.606.208, cerca de 1 em 352.000. Um scanner precisa de centenas de milhares de requisições por achado, o que a limitação de taxa e a detecção de bots podem punir.
Se um destino precisa permanecer privado, o código precisa ser uma capability. Isso significa pelo menos 128 bits de aleatoriedade, o que em base62 são 22 caracteres (62^22 é cerca de 2^131; 21 caracteres dão apenas cerca de 2^125). Também precisa de uma verificação de acesso real por trás. A orientação da OWASP sobre referências diretas inseguras a objetos faz o mesmo ponto: identificadores imprevisíveis ajudam, mas a autorização é o controle. Links protegidos por senha ou com expiração são para os casos em que um código vazado causaria dano. A lista de verificação de segurança de encurtadores de URL lista os controles a combinar com isso, e a mecânica de como os encurtadores funcionam explica por que o código sozinho nunca pode carregar confiança.
A fonte de aleatoriedade importa pelo mesmo motivo. Um gerador com semente e não criptográfico pode ser previsto a partir de algumas saídas, então use o CSPRNG da plataforma, como no trecho acima. Para alternativas prontas, o nanoid implementa a abordagem de escolha sem viés com um alfabeto e comprimento configuráveis.
Qual Abordagem Escolher
Escolha pelo que o código precisa suportar.
- Ferramenta interna, baixo volume: base62 de um ID auto-incremental. Simples, livre de colisão, e a adivinhabilidade não importa.
- Encurtador público, um banco de dados: códigos aleatórios de 7 caracteres com inserir e tentar de novo. Eu começaria aqui. A tabela acima mostra que as chances de colisão permanecem minúsculas por anos, e passar para 8 caracteres depois é uma mudança de uma linha que mantém válidos todos os links existentes.
- Escritas em várias regiões: faixas de contador ou IDs Snowflake como chave interna, mais uma permutação ou um código aleatório para o que o público vê.
- Hash e truncamento: apenas se você precisa de códigos determinísticos, e então trate-o como um código aleatório com uma história de nova tentativa pior.
Qualquer que seja sua escolha, armazene o código em uma coluna com índice único e mantenha a geração fora do caminho de redirecionamento, onde um cache de duas camadas faz o trabalho de verdade (o artigo sobre latência p95 mostra como esse caminho fica quando ajustado). Se você prefere não cuidar da geração de códigos, do tratamento de colisões e das listas de palavras reservadas, a API do Elido recebe um destino e retorna um link curto, com back-halves personalizados validados para você. Veja os planos quando quiser experimentar.
Relacionado no Blog
- Como construir um encurtador de URL - a arquitetura completa sobre a qual este post dá zoom.
- Como os encurtadores de URL funcionam - a introdução conceitual.
- O que é um back-half personalizado? - a metade do espaço de códigos escolhida por humanos.
- Estratégia de cache para redirecionamentos de URL - o que acontece depois que o código existe.
- Vulnerabilidades de redirecionamento aberto - por que o código deve mapear para um destino armazenado.
- Lista de verificação de segurança de encurtadores de URL
Perguntas frequentes
O que é a codificação base62 em um encurtador de URL?
A codificação base62 escreve um número usando 62 símbolos: 0-9, a-z e A-Z. Um encurtador de URL pega um inteiro único, geralmente um ID do banco de dados, e o converte em uma string compacta como 1Ly7. Como todo inteiro é único, todo código base62 é único, então não há colisões a tratar.
Quantas URLs um código curto de 7 caracteres comporta?
Um código base62 de 7 caracteres tem 62^7 = 3.521.614.606.208 valores possíveis, cerca de 3,5 trilhões. A 1.000 novos links por segundo, isso leva aproximadamente 111 anos para se esgotar se você atribuir os códigos sequencialmente. Os códigos aleatórios atingem as primeiras colisões muito antes, por volta de 2,2 milhões de links para 50% de chance de pelo menos uma.
Fazer o hash de uma URL é uma boa forma de gerar um código curto?
Geralmente não. Truncar um hash como o SHA-256 para um código curto descarta a maior parte do digest, então URLs diferentes eventualmente colidem, e você ainda precisa de lógica de nova tentativa. URLs idênticas também são mapeadas para o mesmo código, o que impede de dar a dois usuários links separados com analytics separados.
Como evitar colisões ao gerar URLs curtas?
Ou torne as colisões impossíveis ou torne-as recuperáveis. Codificar um contador único em base62 não pode colidir. Para códigos aleatórios ou de hash, insira com uma restrição de unicidade na coluna do código e tente de novo com um código novo quando a inserção falhar. Verificar e depois inserir é sujeito a condição de corrida; deixe o banco de dados decidir.
Alguém pode adivinhar ou enumerar links curtos?
Sim, se os códigos forem sequenciais. Qualquer pessoa pode percorrer /1, /2, /3 e ler todos os destinos. Códigos aleatórios de 7 caracteres fazem com que um palpite às cegas acerte um link ativo cerca de uma vez a cada 350.000 tentativas com 10 milhões de links, o que atrasa scanners mas não torna um link privado. Trate o código como um endereço, não como uma senha.
Os códigos curtos devem ser sequenciais ou aleatórios?
Use códigos aleatórios para links públicos e IDs sequenciais apenas internamente. Códigos sequenciais são curtos e livres de colisão, mas revelam quantos links existem e permitem que concorrentes os extraiam. Um código aleatório custa uma nova tentativa por restrição de unicidade em casos raros e elimina o problema de enumeração.
Experimente Elido
Cole uma URL, obtenha um link curto
Sem cadastro. O link vive 30 dias. Cadastre-se para mantê-lo para sempre.
Grátis, sem necessidade de registo · 2 por dia