Um cache de redirecionamento de URL é a camada que responde "para onde este slug aponta?" sem consultar o banco de dados toda vez. O nosso tem duas camadas na frente da origem: um pequeno LRU em processo que dura 60 segundos e um cache Redis compartilhado que dura 5 minutos. Se as duas falharem, a borda consulta a origem e preenche as duas na volta.
Esse é o projeto inteiro, e os números importam mais do que o formato. Este artigo percorre as camadas, os TTLs que usamos hoje, como uma edição limpa as duas camadas (e o que acontece se isso falhar) e o outro cache de redirecionamento a que as pessoas costumam se referir ao pesquisar sobre isso: o que fica dentro do navegador. O artigo principal sobre o p95 do redirecionamento cobre o orçamento de latência completo. Este é o texto específico sobre cache.
Escrevi a primeira versão deste artigo com mais confiança do que o código merecia. Reescrevi-o com base no serviço de borda real, então tudo o que está abaixo descreve o que roda agora, incluindo as partes que gostaríamos de melhorar.
Por que um redirecionamento precisa de cache
Um redirecionamento faz uma única consulta: host mais slug entram, destino e regras saem. Nada mais pertence ao caminho da requisição. O destino, o status, a expiração, as regras de segmentação e o limite de cliques ficam todos no registro do link, e esse registro fica no Postgres, atrás da API de origem.
Chamar a origem a cada clique é a opção lenta e frágil. Cada chamada à origem adiciona um salto de rede à requisição, e um soluço do banco de dados viraria uma queda dos redirecionamentos. Por isso a borda mantém os registros recentes por perto e trata a origem como último recurso. Para o usuário, o resultado visível é um redirecionamento que não depende de o painel estar saudável.
As duas camadas, com números reais
Cada consulta segue esta ordem, usando a chave host/slug:
- L1, em processo. Um LRU com expiração que guarda até 100.000 registros de links, cada um por 60 segundos. Ele usa o LRU
expirabledo hashicorp/golang-lru. Um acerto não custa nenhuma rede. - L2, Redis. Um cache compartilhado por todos os processos de borda, com os registros armazenados como JSON sob o prefixo
elido:link:por 5 minutos. Um acerto no L2 também preenche o L1 novamente. - Origem. A API de links via gRPC ou HTTP. É a única camada autorizada a dizer "este link não existe". Um acerto aqui preenche os dois caches.

Dois detalhes passam facilmente despercebidos. Primeiro, um erro do Redis é tratado exatamente como uma falha de cache, então uma queda do Redis deixa os redirecionamentos mais lentos em vez de quebrá-los. Segundo, uma resposta "não encontrado" da origem não é colocada em cache. Erros de digitação e scanners que testam slugs aleatórios vão à origem todas as vezes. Essa é uma lacuna conhecida, e é a primeira coisa que eu corrigiria se o tráfego de sondagem algum dia importasse.
Também não agrupamos hoje as falhas simultâneas. Se um link frio recebe uma rajada de cliques no mesmo instante, cada um deles pode chegar à origem. Isso não nos prejudicou, mas é um limite que você deve conhecer antes de copiar este projeto.
Por que o L1 dura apenas 60 segundos
Um cache em processo não pode ser compartilhado, então cada processo de borda guarda a sua própria cópia. Para limpá-lo de fora, todo processo de borda assina em segundo plano um canal pub/sub do Redis e descarta uma chave quando chega uma mensagem de invalidação. O TTL de 60 segundos é a rede de segurança por trás disso: curto o bastante para que uma mensagem perdida se corrija rápido, longo o bastante para que um link com tráfego constante seja servido da memória quase sempre.
O mesmo raciocínio explica o limite de tamanho. 100.000 entradas cobrem um conjunto de trabalho quente porque o tráfego de redirecionamento é muito concentrado. Uma pequena parcela dos slugs recebe a maior parte dos cliques, e o resto pode cair para o L2 sem que ninguém perceba.
Se você está dimensionando o seu próprio, comece pelo TTL. Escolha a defasagem que você consegue defender diante de um cliente e depois trabalhe de trás para frente até a taxa de acertos que ela lhe dá.
Como as edições chegam à borda
Quando alguém edita um link, o Postgres é atualizado primeiro. Logo depois que a gravação é salva, o api-core apaga a chave do link no Redis e publica uma mensagem de invalidação em elido:link:invalidate. Todo processo de borda está escutando e descarta a sua cópia em memória. O clique seguinte falha nas duas camadas e carrega o novo registro da origem. Os visitantes veem a mudança em um ou dois segundos.
A limpeza cobre mais do que o destino: regras de segmentação, senha, expiração, limite de cliques, status, tipo de redirecionamento, uma troca de slug (tanto a URL curta antiga quanto a nova são limpas, então a antiga para de resolver na hora), exclusões, restaurações da lixeira, mudanças de status em massa, variantes de teste A/B, um novo veredito do scanner, a anexação de uma sobreposição de CTA e a rotação de criptografia. Não há configuração; todo plano recebe isso.
Uma condição de corrida exigiu uma segunda passada. Uma consulta que começou pouco antes da gravação pode ler a linha antiga e colocá-la de volta no Redis depois da limpeza. Por isso o api-core limpa mais uma vez, 2 segundos depois, o que fecha essa janela.
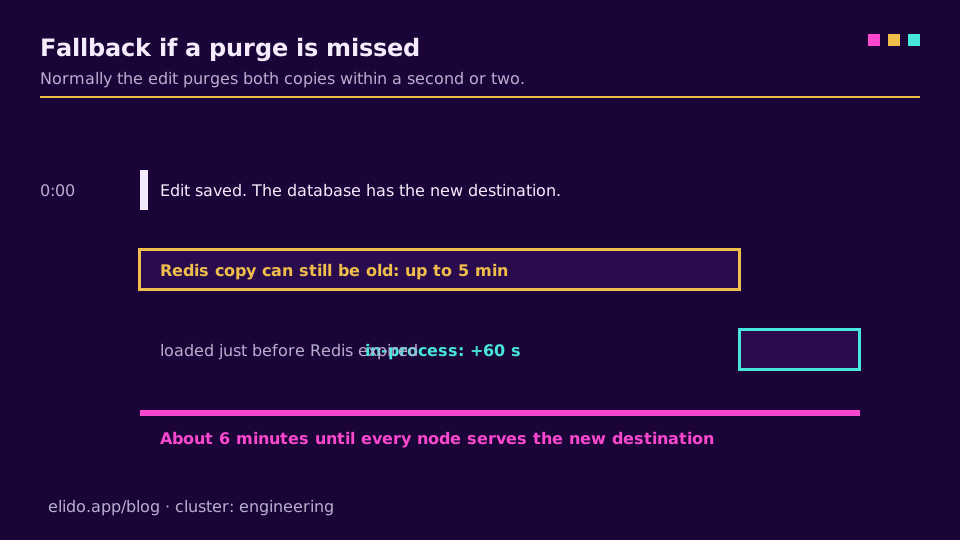
A limpeza é de melhor esforço e nunca fica no caminho do redirecionamento. Se o Redis estiver brevemente indisponível, os TTLs assumem como reserva, e o pior caso é o antigo: o L2 pode guardar o registro antigo por até 5 minutos, e um processo de borda pode carregá-lo no L1 pouco antes de o L2 expirar e mantê-lo por mais 60 segundos, cerca de seis minutos no total.
Nem tudo é limpo por link. Mudanças no nível do workspace, como pixels, identidade visual, edições no conteúdo de uma sobreposição de CTA e configurações de todo o domínio, ainda seguem os TTLs normais, a menos que uma ação de administrador já as tenha limpado.
Para um lançamento ou uma retirada, isso significa que você pode mudar o destino no momento em que precisar e conferi-lo com curl -I alguns segundos depois. Antes de a limpeza existir, o conselho aqui era agendar as mudanças seis minutos antes. Você não precisa mais disso.
Aquecimento de cache e partidas a frio
Não pré-aquecemos nada. Um Redis novo começa vazio e se preenche conforme os links recebem cliques. Um processo de borda recém-iniciado começa com o L1 vazio e recorre ao Redis nas primeiras requisições, depois se preenche conforme os links são usados.
Isso é entediante de propósito. Como toda camada trabalha no melhor esforço e a origem é a autoridade, um cache frio custa latência no primeiro clique de cada link, nunca correção. Se lhe disseram que você precisa de um botão de pré-aquecimento, pergunte primeiro qual é de fato a latência do clique a frio. Para a maioria das cargas, ninguém consegue perceber.
O outro cache de redirecionamento: o seu navegador
A maioria das pesquisas por "cache de redirecionamento" trata de um cache completamente diferente, e ele causa mais chamados de suporte do que o nosso. Os navegadores armazenam em cache as respostas de redirecionamento, e o código de status decide com que força.
Um 301 é "permanente". A especificação de cache HTTP (RFC 9111) o trata como armazenável em cache por padrão, e os navegadores historicamente o guardam sem expiração quando nenhum cabeçalho diz o contrário. O texto de Rowan Collins descreve a armadilha clássica: um redirecionamento é armazenado em cache, a URL é reutilizada depois e os visitantes com a cópia antiga ficam indo e voltando para sempre. Um 302 ou 307 só é reutilizado quando um cabeçalho de validade o permite. O guia de cache da MDN é a referência mais clara sobre os cabeçalhos envolvidos: max-age define a validade, private restringe o armazenamento ao navegador e no-store impede o armazenamento por completo.
As nossas respostas de redirecionamento enviam Cache-Control: private, max-age=0, no-store, seja qual for o status usado pelo link: 301, 302 ou 307. Os navegadores, portanto, consultam a borda de novo no clique seguinte. É uma troca deliberada. Você perde um pouco de velocidade nas visitas repetidas e ganha duas coisas: todo clique é contado e uma edição de destino não fica presa no navegador de alguém. As páginas intersticiais de links desativados, expirados ou inexistentes também são no-store, então um link que volta à vida não é mascarado por um erro em cache.
Se você mantém os seus próprios redirecionamentos, escolha o status de propósito. Nosso guia de 301 vs 302 e a visão geral dos tipos de redirecionamento explicam quando cada um se encaixa.
Limpando um redirecionamento em cache no Chrome
Se um navegador está preso em um 301 antigo, corrija o servidor primeiro e depois limpe a cópia do navegador:
- Abra o DevTools e mude para a aba Network.
- Marque Preserve log e limpe o log.
- Carregue a URL que redireciona para que a requisição de redirecionamento apareça.
- Clique com o botão direito nessa requisição e limpe o cache do navegador para ela.
Um hard refresh comum muitas vezes não resolve. Para uma verificação rápida sem mexer no seu perfil normal, carregue a URL em uma janela anônima ou execute curl -I https://your.short/link para ver o status e os cabeçalhos reais sem nenhum cache de navegador envolvido. Se você encadeia vários redirecionamentos, um salto antigo em cache também é uma causa clássica de loops. Veja como corrigir um loop de redirecionamento.
O que cada escolha custa
Todo número acima é uma troca que você pode mover.
- Aumentar o TTL do L1 economiza algumas leituras no Redis, ao preço de uma janela de defasagem maior sempre que uma mensagem de invalidação for perdida. Encontramos pouca razão para isso.
- Aumentar o TTL do L2 reduz o tráfego na origem, mas uma limpeza perdida demora mais para se corrigir. Cinco minutos foram o nosso meio-termo.
- Dispensar o L2 exige mais capacidade de origem em cada nó de borda, já que nada é compartilhado entre processos.
- Deixar os navegadores fazerem cache (301 sem
no-store) reduz o tráfego repetido, mas você perde a contagem precisa de cliques e a possibilidade de mudar de ideia.
Um cache de duas camadas com limpeza na escrita serve quando as leituras dominam as escritas, a distribuição das chaves é concentrada e alguns minutos de defasagem são aceitáveis no caso raro de uma limpeza se perder. Serve mal quando os destinos mudam com frequência e precisam mudar instantaneamente, ou quando cada requisição é única.
Observando de fora
Você não vê os nossos contadores de cache, mas vê os efeitos deles. Uma sonda sintética que registra a latência e o status do redirecionamento mostra uma primeira requisição lenta após um deploy e uma latência estável depois disso. O painel de latência de redirecionamento do Datadog percorre essa configuração, e a ingestão de cliques fire-and-forget cobre o que acontece com cada clique depois que o redirecionamento é servido.
Se você quer links curtos de marca no seu próprio domínio com esse comportamento já resolvido, domínios personalizados é por onde começar, e a página de preços mostra qual plano inclui quantos domínios.
Relacionado no blog
- Orçamento de Latência: Como o Elido Mira p95 Abaixo de 15ms - o artigo principal do cluster de engenharia.
- Redirecionamentos 301 vs 302: Qual Usar em Links Curtos - qual status enviar e o que ele significa para navegadores e buscadores.
- Tipos de Redirecionamentos de URL: 301, 302, 307, 308 e Mais - a lista completa dos códigos 3xx e quando cada um se aplica.
- Loop de Redirecionamento: Como Encontrar e Corrigir o ERR_TOO_MANY_REDIRECTS - saltos em cache são um culpado comum.
- Cadeia de Redirecionamentos e SEO: Quantos Saltos São Demais? - o que os saltos extras custam.
- Cliques fire-and-forget: analytics fora do hot path - o que acontece com cada clique depois do redirecionamento.
Perguntas frequentes
Os navegadores fazem cache de redirecionamentos 301?
Sim, e de forma agressiva. Um 301 sem cabeçalhos de cache pode ser armazenado em cache, e alguns navegadores o guardam sem expiração, então o navegador pode continuar indo para o destino antigo depois que você o altera no servidor. Um cabeçalho Cache-Control com no-store ou um max-age curto é o que impede isso.
Os redirecionamentos 302 são armazenados em cache?
Não por padrão. Um 302 é temporário, então os navegadores só o reutilizam quando um cabeçalho Cache-Control ou Expires diz que ele ainda é válido. Por isso o 302 é a escolha mais segura enquanto você ainda está testando um redirecionamento.
Como limpo um redirecionamento em cache no Chrome?
Corrija o servidor primeiro, depois abra o DevTools, vá para a aba Network, marque Preserve log, carregue a URL que redireciona e limpe o cache dessa requisição. Um hard refresh comum muitas vezes deixa o redirecionamento em cache no lugar. Testar em uma janela anônima é a verificação rápida.
Qual deve ser o TTL do cache de redirecionamento?
Tão longo quanto você tolerar um destino desatualizado se uma limpeza for perdida. Usamos 60 segundos em processo e 5 minutos no cache compartilhado, e toda edição limpa os dois, então uma mudança normalmente aparece em um ou dois segundos. Os TTLs são a reserva: se a limpeza falhar, uma edição pode levar cerca de seis minutos para aparecer para todos.
Por que meu link curto ainda vai para a URL antiga depois que eu o editei?
No Elido, uma edição limpa as cópias da borda em um ou dois segundos, então, depois disso, a causa habitual é o seu navegador ou um redirecionamento na frente do Elido que armazenou um 301 anterior. Verifique com curl -I para ver a resposta real e depois teste em uma janela anônima para descartar o navegador.
O Elido deixa os navegadores fazerem cache dos seus redirecionamentos?
Não. A resposta de redirecionamento traz Cache-Control private, max-age=0, no-store, mesmo para links configurados como 301. Todo clique chega à borda, o que mantém a contagem de cliques honesta e permite mudar um destino sem esperar pelos navegadores.
Experimente Elido
Cole uma URL, obtenha um link curto
Sem cadastro. O link vive 30 dias. Cadastre-se para mantê-lo para sempre.
É necessária uma conta grátis. O plano grátis inclui 25 links no total. Já tem uma conta? Entrar