La generación de códigos cortos se reduce a cuatro opciones: codificar un contador único en base62, sacar caracteres al azar, truncar un hash de la URL o repartir rangos de ID desde un coordinador. Los contadores nunca colisionan, pero son adivinables. Los códigos aleatorios no son adivinables, pero necesitan una vía de reintento. El hash con truncado es la más débil de las cuatro, porque colisiona antes de lo que la gente espera y no te da nada que no den las demás.
Los números deciden la mayor parte, así que este artículo los trabaja. Un código base62 de 7 caracteres tiene exactamente 3.521.614.606.208 valores, y uno aleatorio tiene un 50 % de probabilidad de al menos una colisión tras unos 2,2 millones de enlaces. El primer hecho hace que 7 caracteres parezcan enormes. El segundo es el límite del cumpleaños, y es la razón por la que "billones de posibilidades" no significa "sin colisiones".
Si quieres el sistema completo alrededor del código (almacenamiento, redirecciones, caché), empieza por cómo construir un acortador de URL. Este es el zoom sobre una decisión de ese recorrido: de dónde sale el código corto.
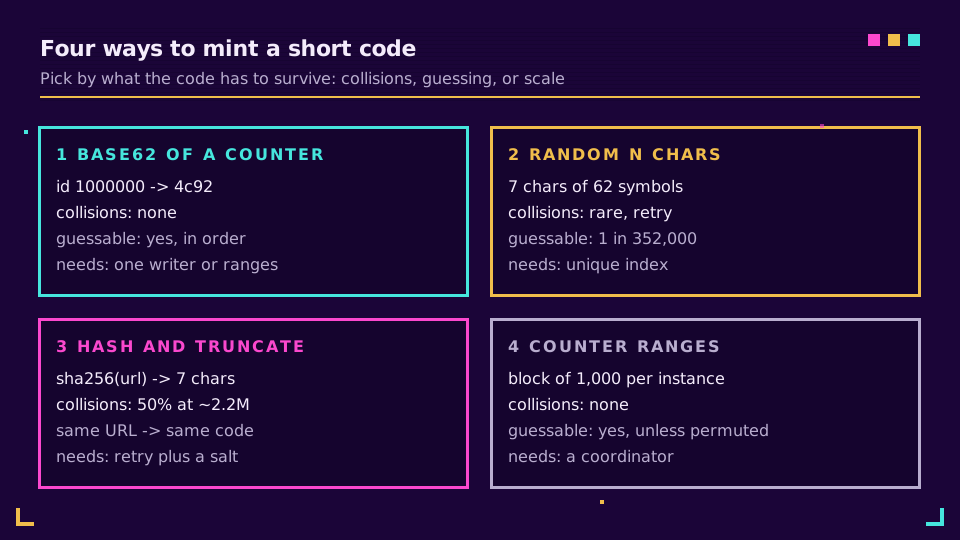
Codificación base62 de un ID autoincremental
La codificación base62 convierte un número en una cadena sobre los 62 símbolos 0-9, a-z, A-Z. Es la misma idea que el hexadecimal con un alfabeto mayor, y es la forma de texto seguro para URL más corta de un entero que evita los signos de puntuación. El ID 125 pasa a ser 21 (2 x 62 + 1), y 1,000,000 pasa a ser 4c92.
const ALPHABET =
  "0123456789abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ";

export function encode(id: bigint): string {
  if (id === 0n) return ALPHABET[0];
  let out = "";
  while (id > 0n) {
    out = ALPHABET[Number(id % 62n)] + out;
    id /= 62n;
  }
  return out;
}

export function decode(code: string): bigint {
  let id = 0n;
  for (const ch of code) id = id * 62n + BigInt(ALPHABET.indexOf(ch));
  return id;
}
La fortaleza es que la unicidad se hereda de la base de datos. La fila 41.000.000 recibe un código y nadie más lo recibirá jamás. No hay bucle de reintento ni consulta previa a la inserción. Los códigos también crecen despacio: los ID por debajo de 62^6 dan códigos de seis caracteres o menos, y el primer código de 7 caracteres aparece en el ID 56.800.235.584.
La debilidad es la exposición. El código es el número de fila disfrazado, así que decode("4c92") devuelve 1000000. Cualquiera puede contar tus enlaces, estimar tu crecimiento a partir de dos muestras con una semana de diferencia y recorrer cada código en orden. Para una herramienta interna eso está bien. Para un acortador público es una API de extracción gratuita, lo que importa para los riesgos de redirección abierta y de enumeración tratados en otro lugar de este blog.
Puedes ocultar el orden sin perder la unicidad pasando el ID por una permutación invertible (una pequeña red de Feistel es la opción habitual) antes de codificar. Ten cuidado con los atajos. Multiplicar por una constante módulo 62^7 parece revuelto, pero mantiene el último dígito incrementándose, como muestra una prueba rápida. Un contador revuelto es ofuscación, no secreto.
Códigos aleatorios: espacio de claves, reintentos y el límite del cumpleaños
Un código corto aleatorio saca cada carácter del alfabeto de forma independiente. Usa una fuente criptográfica y una elección sin sesgo. randomInt(62) en Node hace el muestreo por rechazo por ti, mientras que byte % 62 sesga la distribución porque 256 no es múltiplo de 62.
import { randomInt } from "node:crypto";

export function randomCode(length = 7): string {
  let out = "";
  for (let i = 0; i < length; i++) out += ALPHABET[randomInt(62)];
  return out;
}
¿Qué longitud debe tener el código? El espacio de claves es 62^longitud, y la paradoja del cumpleaños dice que, entre n sorteos aleatorios de N valores, la probabilidad de al menos una repetición es aproximadamente 1 - e^(-n²/2N). Llega al 50 % en torno a sqrt(2N ln 2) sorteos. La paradoja del cumpleaños es contraintuitiva porque los pares crecen con el cuadrado de n.
| Longitud | Espacio de claves (62^L) | Códigos aleatorios hasta un 50 % de probabilidad de repetición | Probabilidad de que una nueva inserción colisione con 100 M de enlaces |
|---|---|---|---|
| 6 | 56.800.235.584 | unos 280.600 | 1 entre 568 (0,18 %) |
| 7 | 3.521.614.606.208 | unos 2.209.500 | 1 entre 35.216 (0,0028 %) |
| 8 | 218.340.105.584.896 | unos 17.397.800 | 1 entre 2.183.401 (0,000046 %) |
La última columna es la cifra que importa operativamente. Una repetición entre todos tus enlaces es casi segura a escala, pero lo que tu código experimenta de verdad es una única inserción que choca con un hueco ocupado, y esa probabilidad es simplemente enlaces / espacio de claves. Con 100 millones de enlaces y 7 caracteres, una inserción de cada 35.000 aproximadamente colisiona. Lo verás en producción, así que necesitas una vía de reintento, pero es barata.
Gestión de colisiones: que decida la base de datos
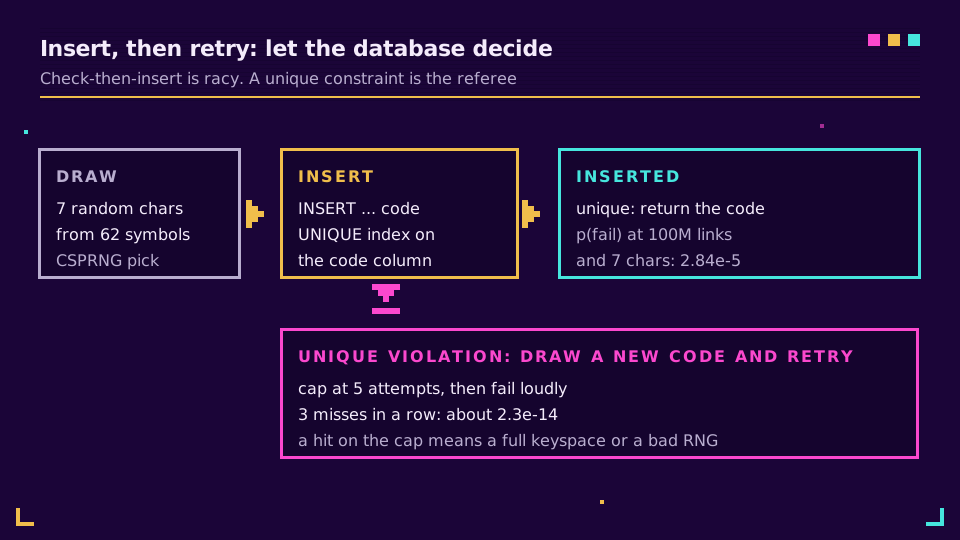
El patrón que funciona es insertar y reintentar, no comprobar y luego insertar. Dos solicitudes pueden comprobar ambas que aB3x9Qz está libre y después escribirlo las dos. Una restricción de unicidad en la columna del código cierra esa condición de carrera, y la inserción fallida es tu señal para sacar otro código.
export async function createWithRetry(
  tryInsert: (code: string) => Promise<boolean>, // false = unique violation
  attempts = 5,
): Promise<string> {
  for (let i = 0; i < attempts; i++) {
    const code = randomCode();
    if (await tryInsert(code)) return code;
  }
  throw new Error("could not allocate a short code");
}
Aquí tryInsert ejecuta tu INSERT y devuelve false solo ante un error de violación de unicidad, nunca ante otros fallos. Si una única inserción colisiona con probabilidad p, todos los intentos fallan con probabilidad p^intentos. En el punto de 100 M de enlaces y 7 caracteres, p es 2,84 x 10^-5, así que tres fallos seguidos son aproximadamente 2,3 x 10^-14. Limita los intentos de todos modos. Si alguna vez ves que se alcanza el límite, el espacio de claves está casi lleno o la fuente aleatoria está rota, y un error ruidoso es mejor que un bucle infinito.
La misma disciplina se aplica a la idempotencia en el endpoint de creación, porque una solicitud HTTP reintentada no debe acuñar un segundo enlace. Límites de frecuencia e idempotencia cubre esa otra mitad.
Hash y truncado: por qué colisiona antes de lo que crees
Hacer un hash de la URL resulta atractivo porque es determinista: la misma URL da siempre el mismo código, así que puedes evitar una consulta de duplicados. El coste es que un código solo tiene unos pocos bits que gastar. Tomar 32 bits de un resumen da 2^32 = 4.294.967.296 valores, y el punto de colisión del 50 % está en unas 77.163 URL. No miles de millones. Un fragmento base62 de 7 caracteres (unos 41,7 bits) lo lleva a aproximadamente 2,2 millones, que es lo mismo que un código aleatorio de 7 caracteres.
import { createHash } from "node:crypto";

export function hashCode(url: string, length = 7): string {
  const digest = createHash("sha256").update(url).digest();
  const n = digest.readBigUInt64BE(0) % 62n ** BigInt(length);
  return encode(n).padStart(length, "0");
}
Así que el truncado no rompe el hash. SHA-256 está bien. La resistencia a colisiones de los 256 bits completos simplemente no sobrevive a recortarse a 41 bits. Heredas el comportamiento de un código aleatorio, así que sigues necesitando la vía de reintento, más una regla para qué hacer ante un choque (añadir sal y volver a calcular el hash). Y el determinismo va en tu contra: dos clientes que acortan la misma URL obtienen el mismo código y, por tanto, el mismo flujo de clics, a menos que mezcles un ID de cuenta. Yo evitaría el hash con truncado en casi todos los casos. Si quieres deduplicar, busca la URL por una columna de hash y genera el código de otra manera.
Rangos de contador e ID al estilo Snowflake
Una única columna autoincremental se convierte en un cuello de botella cuando varios escritores en varias regiones necesitan ID. Dos patrones lo evitan sin renunciar a la unicidad.
El primero son los rangos de contador. Un coordinador entrega a cada instancia de aplicación un bloque, digamos 1.000 ID, y la instancia los codifica localmente sin un viaje de ida y vuelta por enlace. Si una instancia muere, su bloque sin usar simplemente se salta. Los huecos en un espacio de códigos de billones son inofensivos.
El segundo es un ID al estilo Snowflake: una marca de tiempo, un ID de máquina y una secuencia por milisegundo empaquetados en 64 bits. Estos se ordenan por hora de creación y no necesitan coordinador. La pega para los enlaces cortos es la longitud. Un valor de 64 bits llega hasta 18.446.744.073.709.551.615, y como 62^10 = 839.299.365.868.340.224 es menor que 2^64, necesita hasta 11 caracteres base62. Eso no es muy corto. Los ID Snowflake encajan mejor como claves de base de datos que como códigos públicos, así que la mayoría de los acortadores los mantiene internos y usa un código aparte, más corto.
Ambos heredan el problema de la adivinabilidad secuencial, porque ambos están ordenados por construcción. Envuélvelos en una permutación, o usa uno de ellos solo como clave primaria interna.
Códigos personalizados y palabras reservadas
Los slugs personalizados son el único lugar donde una persona elige el código, y pasan por la misma restricción de unicidad que todo lo demás. El trabajo adicional es la validación antes de la inserción. Una parte final personalizada como /spring-sale hay que contrastarla con tres cosas.
- Palabras reservadas. Las rutas que tu aplicación o la web ya usan nunca deben poder reclamarse:
api,admin,login,static,robots.txt,favicon.icoy.well-known. Un acortador que deja registrar/loginha construido un generador de páginas de phishing. - Colisiones con códigos generados. Si un usuario toma
/aB3x9Qz, tu generador aleatorio puede producir más tarde la misma cadena. La restricción de unicidad lo gestiona, siempre que los códigos personalizados y los generados compartan un único espacio de nombres. - Mayúsculas y caracteres parecidos. Base62 distingue mayúsculas de minúsculas, así que
/Aby/abson enlaces distintos. Decide si los slugs personalizados se comparan sin distinguir mayúsculas, y considera bloquear los pares que solo se diferencian en0/Ool/1. La guía de URL personalizadas cubre el lado de la marca.
Los códigos aleatorios de 7 caracteres también pueden formar algo desafortunado. Pasa los códigos generados por una breve lista de bloqueo y vuelve a sacar uno si hay una coincidencia. Cuesta casi nada.
Enumeración, adivinabilidad y privacidad
Un código corto es una dirección. No es un secreto, y ninguna longitud lo convierte en uno. Aun así, la diferencia entre secuencial y aleatorio es grande. Con códigos secuenciales, cada conjetura da con un enlace activo. Con 10 millones de enlaces repartidos al azar entre 62^7 valores, una conjetura a ciegas da con uno con probabilidad 10.000.000 / 3.521.614.606.208, aproximadamente 1 entre 352.000. Un escáner necesita cientos de miles de solicitudes por cada hallazgo, algo que la limitación de frecuencia y la detección de bots pueden castigar.
Si un destino debe seguir siendo privado, el código tiene que ser una capacidad. Eso significa al menos 128 bits de aleatoriedad, que en base62 son 22 caracteres (62^22 es aproximadamente 2^131; 21 caracteres dan solo unos 2^125). También necesita una comprobación de acceso real detrás. La guía de OWASP sobre referencias directas inseguras a objetos plantea lo mismo: los identificadores impredecibles ayudan, pero el control es la autorización. Los enlaces protegidos con contraseña o con caducidad son para los casos en que un código filtrado haría daño. La lista de comprobación de seguridad de un acortador de URL enumera los controles que conviene combinar con ello, y la mecánica de cómo funcionan los acortadores explica por qué el código por sí solo nunca puede transmitir confianza.
La fuente de aleatoriedad importa por la misma razón. Un generador no criptográfico con semilla puede predecirse a partir de unas pocas salidas, así que usa el CSPRNG de la plataforma, como en el fragmento de arriba. Como alternativa ya hecha, nanoid implementa el enfoque de elección sin sesgo con un alfabeto y una longitud configurables.
Qué enfoque elegir
Elige según lo que tenga que sobrevivir el código.
- Herramienta interna, bajo volumen: base62 de un ID autoincremental. Sencillo, sin colisiones, y la adivinabilidad no importa.
- Acortador público, una base de datos: códigos aleatorios de 7 caracteres con inserción y reintento. Yo empezaría aquí. La tabla de arriba muestra que las probabilidades de colisión siguen siendo diminutas durante años, y pasar a 8 caracteres más tarde es un cambio de una línea que mantiene válidos todos los enlaces existentes.
- Escrituras multirregión: rangos de contador o ID Snowflake como clave interna, más una permutación o un código aleatorio para lo que ve el público.
- Hash con truncado: solo si necesitas códigos deterministas, y entonces trátalo como un código aleatorio con una peor historia de reintentos.
Elijas lo que elijas, guarda el código en una columna con índice único y mantén la generación fuera de la ruta de redirección, donde una caché de dos niveles hace el trabajo real (el artículo sobre la latencia p95 muestra cómo es esa ruta cuando está afinada). Si prefieres no encargarte de la generación de códigos, la gestión de colisiones y las listas de palabras reservadas, la API de Elido recibe un destino y devuelve un enlace corto, con las partes finales personalizadas validadas por ti. Consulta los planes cuando quieras probarlo.
Relacionado en el blog
- Cómo construir un acortador de URL - la arquitectura completa sobre la que hace zoom este artículo.
- Cómo funcionan los acortadores de URL - la introducción conceptual.
- ¿Qué es una parte final personalizada? - la mitad del espacio de códigos que elige una persona.
- Estrategia de caché para las redirecciones de URL - lo que ocurre una vez que existe el código.
- Vulnerabilidades de redirección abierta - por qué el código debe corresponder a un destino almacenado.
- Lista de comprobación de seguridad de un acortador de URL
Preguntas frecuentes
¿Qué es la codificación base62 en un acortador de URL?
La codificación base62 escribe un número usando 62 símbolos: 0-9, a-z y A-Z. Un acortador de URL toma un entero único, normalmente un ID de base de datos, y lo convierte en una cadena compacta como 1Ly7. Como cada entero es único, cada código base62 es único, así que no hay colisiones que gestionar.
¿Cuántas URL puede contener un código corto de 7 caracteres?
Un código base62 de 7 caracteres tiene 62^7 = 3.521.614.606.208 valores posibles, unos 3,5 billones. A 1.000 enlaces nuevos por segundo, agotarlo lleva aproximadamente 111 años si asignas los códigos de forma secuencial. Los códigos aleatorios alcanzan sus primeras colisiones mucho antes, alrededor de 2,2 millones de enlaces para una probabilidad del 50 % de que haya al menos una.
¿Es el hash de una URL una buena forma de generar un código corto?
Normalmente no. Truncar un hash como SHA-256 a un código corto descarta la mayor parte del resumen, así que URL distintas acaban colisionando, y sigues necesitando lógica de reintento. Además, URL idénticas se asignan al mismo código, lo que te impide dar a dos usuarios enlaces separados con analítica separada.
¿Cómo se evitan las colisiones al generar URL cortas?
O haces imposibles las colisiones o las haces recuperables. Codificar un contador único en base62 no puede colisionar. Para códigos aleatorios o con hash, inserta con una restricción de unicidad en la columna del código y reintenta con un código nuevo cuando falle la inserción. Comprobar y luego insertar es propenso a condiciones de carrera; deja que decida la base de datos.
¿Puede alguien adivinar o enumerar los enlaces cortos?
Sí, si los códigos son secuenciales. Cualquiera puede recorrer /1, /2, /3 y leer cada destino. Los códigos aleatorios de 7 caracteres hacen que una conjetura a ciegas dé con un enlace activo aproximadamente una vez cada 350.000 intentos con 10 millones de enlaces, lo que frena a los escáneres pero no hace privado un enlace. Trata el código como una dirección, no como una contraseña.
¿Deben ser los códigos cortos secuenciales o aleatorios?
Usa códigos aleatorios para los enlaces públicos y los ID secuenciales solo internamente. Los códigos secuenciales son cortos y no tienen colisiones, pero revelan cuántos enlaces existen y permiten que los competidores los extraigan. Un código aleatorio te cuesta un reintento por restricción de unicidad en casos raros y elimina el problema de la enumeración.
Prueba Elido
Pega una URL, obtén un enlace corto
Sin registro. El enlace vive 30 días. Crea una cuenta para conservarlo.
Gratis, sin registro · 2 por día