Una caché de redirecciones URL es la capa que responde a "¿a dónde apunta este slug?" sin preguntar a la base de datos cada vez. La nuestra tiene dos niveles delante del origen: un pequeño LRU en proceso que vive 60 segundos y una caché Redis compartida que vive 5 minutos. Si ambos fallan, el edge pregunta al origen y rellena los dos al volver.
Ese es todo el diseño, y los números importan más que la forma. Este artículo recorre los niveles, los TTL que usamos hoy, cómo una edición vacía ambos niveles (y qué pasa si eso falla) y la otra caché de redirecciones a la que suele referirse la gente cuando busca esto: la que está dentro del navegador. El pilar sobre el p95 de redirección cubre el presupuesto de latencia completo. Esta es la pieza específica de caché.
Escribí la primera versión de este artículo con más seguridad de la que merecía el código. Lo he reescrito contra el servicio edge real, así que todo lo que sigue describe lo que funciona ahora, incluidas las partes que nos gustaría mejorar.
Por qué una redirección necesita una caché
Una redirección hace una sola consulta: entran host y slug, salen destino y reglas. Nada más pertenece a la ruta de la petición. El destino, el estado, la caducidad, las reglas de segmentación y el límite de clics viven en el registro del enlace, y ese registro vive en Postgres detrás de la API de origen.
Llamar al origen por cada clic es la opción lenta y frágil. Cada llamada al origen añade un salto de red a la petición, y un contratiempo de la base de datos se convertiría en una caída de las redirecciones. Por eso el edge mantiene cerca los registros recientes y trata el origen como último recurso. Para el usuario, el resultado visible es una redirección que no depende de que el panel esté sano.
Los dos niveles, con números reales
Cada consulta se ejecuta en este orden, con la clave host/slug:
- L1, en proceso. Un LRU con caducidad que guarda hasta 100.000 registros de enlaces, cada uno durante 60 segundos. Usa el LRU
expirablede hashicorp/golang-lru. Un acierto no cuesta nada de red. - L2, Redis. Una caché compartida por todos los procesos edge, con los registros guardados como JSON bajo el prefijo
elido:link:durante 5 minutos. Un acierto en L2 también vuelve a rellenar L1. - Origen. La API de enlaces por gRPC o HTTP. Es la única capa autorizada a decir "este enlace no existe". Un acierto aquí rellena ambas cachés.

Hay dos detalles fáciles de pasar por alto. Primero, un error de Redis se trata exactamente como un fallo de caché, de modo que una caída de Redis ralentiza las redirecciones en lugar de romperlas. Segundo, una respuesta "no encontrado" del origen no se cachea. Las erratas y los escáneres que sondean slugs aleatorios van al origen cada vez. Es una laguna conocida, y es lo primero que arreglaría si el tráfico de sondeo llegara a importar.
Tampoco unificamos hoy los fallos concurrentes. Si un enlace frío recibe una ráfaga de clics en el mismo instante, cada uno puede llegar al origen. No nos ha perjudicado, pero es un límite que conviene conocer antes de copiar este diseño.
Por qué L1 dura solo 60 segundos
Una caché en proceso no se puede compartir, así que cada proceso edge guarda su propia copia. Para vaciarla desde fuera, cada proceso edge se suscribe en segundo plano a un canal pub/sub de Redis y descarta una clave cuando llega un mensaje de invalidación. El TTL de 60 segundos es la red de seguridad que hay detrás: lo bastante corto para que un mensaje perdido se cure rápido, lo bastante largo para que un enlace con tráfico constante se sirva casi siempre desde memoria.
El mismo razonamiento explica el límite de tamaño. 100.000 entradas cubren un conjunto de trabajo caliente porque el tráfico de redirecciones está muy sesgado. Una pequeña parte de los slugs recibe la mayoría de los clics, y el resto puede caer a L2 sin que nadie lo note.
Si dimensionas la tuya, empieza por el TTL. Elige la obsolescencia que puedas defender ante un cliente y calcula hacia atrás la tasa de aciertos que te da.
Cómo llegan las ediciones al edge
Cuando alguien edita un enlace, Postgres se actualiza primero. Justo después de guardar la escritura, api-core borra la clave de Redis del enlace y publica un mensaje de invalidación en elido:link:invalidate. Cada proceso edge está escuchando y descarta su copia en memoria. El siguiente clic falla en ambos niveles y carga el registro nuevo desde el origen. Los visitantes ven el cambio en uno o dos segundos.
La purga cubre más que el destino: reglas de segmentación, contraseña, caducidad, límite de clics, estado, tipo de redirección, un cambio de slug (se limpian tanto la URL corta antigua como la nueva, así que la antigua deja de resolverse al instante), eliminaciones, restauraciones desde la papelera, cambios de estado en lote, variantes A/B, un nuevo veredicto del escáner, adjuntar una capa CTA y rotar el cifrado. No hay ningún ajuste; todos los planes lo tienen.
Una condición de carrera necesitó una segunda pasada. Una consulta que empezó justo antes de la escritura puede leer la fila antigua y volver a ponerla en Redis después de la purga. Por eso api-core purga una vez más 2 segundos después, lo que cierra esa ventana.
La purga es de mejor esfuerzo y nunca está en la ruta de la redirección. Si Redis no está disponible un momento, los TTL toman el relevo como plan de reserva, y el peor caso es el de siempre: L2 puede conservar el registro antiguo hasta 5 minutos, y un proceso edge puede cargarlo en L1 justo antes de que expire L2 y conservarlo otros 60 segundos, unos seis minutos en total.
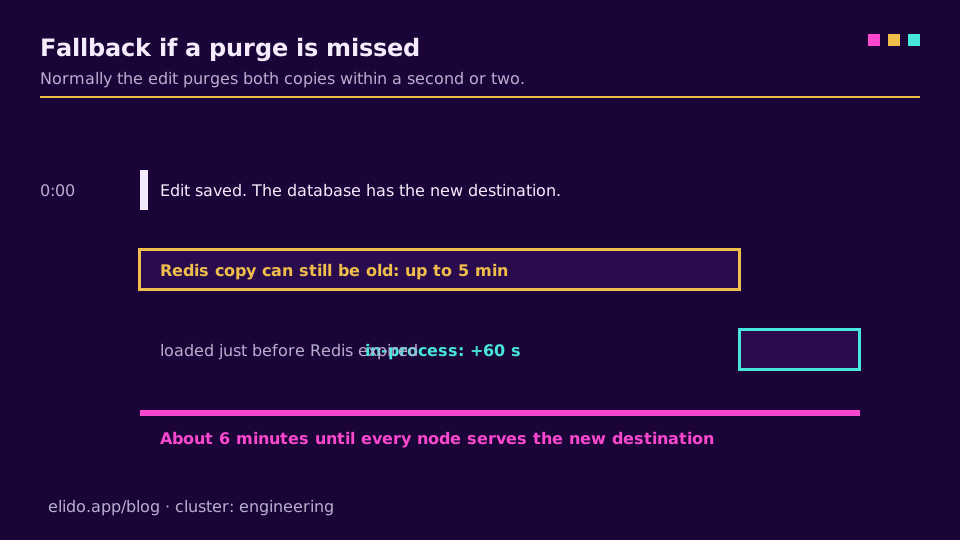
Ese es el plan de reserva, no el camino normal. En funcionamiento normal, la purga lo deja en uno o dos segundos.
No todo se purga por enlace. Los cambios a nivel de espacio de trabajo, como píxeles, marca, ediciones del contenido de una capa CTA y ajustes de todo el dominio, siguen los TTL normales salvo que una acción de administrador ya los haya vaciado.
Para un lanzamiento o una retirada, eso significa que puedes cambiar el destino en el momento que lo necesites y comprobarlo con curl -I unos segundos después. Antes de que existiera la purga, el consejo aquí era programar los cambios seis minutos antes. Ya no hace falta.
Calentamiento de la caché y arranques en frío
No precalentamos nada. Un Redis nuevo arranca vacío y se llena a medida que se hace clic en los enlaces. Un proceso edge recién iniciado arranca con L1 vacío y cae a Redis en las primeras peticiones; luego se llena según se usan los enlaces.
Esto es aburrido a propósito. Como cada capa es de mejor esfuerzo y el origen es la autoridad, una caché fría cuesta latencia en el primer clic por enlace, nunca corrección. Si te han dicho que necesitas un botón de precalentamiento, pregunta primero cuál es realmente la latencia del clic en frío. Para la mayoría de las cargas, nadie la ve.
La otra caché de redirecciones: tu navegador
La mayoría de las búsquedas de "caché de redirecciones" tratan de una caché totalmente distinta, y causa más tickets de soporte que la nuestra. Los navegadores cachean las respuestas de redirección, y el código de estado decide con qué insistencia.
Una 301 es "permanente". La especificación de caché HTTP (RFC 9111) la trata como cacheable por defecto, y los navegadores la han guardado históricamente sin caducidad cuando ninguna cabecera dice lo contrario. El artículo de Rowan Collins describe la trampa clásica: se cachea una redirección, la URL se reutiliza más tarde y los visitantes con la copia antigua rebotan sin fin. Una 302 o 307 solo se reutiliza cuando una cabecera de frescura lo permite. La guía de caché de MDN es la referencia más clara de las cabeceras implicadas: max-age fija la frescura, private limita el almacenamiento al navegador y no-store impide el almacenamiento por completo.
Nuestras respuestas de redirección envían Cache-Control: private, max-age=0, no-store, sea 301, 302 o 307 el estado que use el enlace. Por tanto, los navegadores vuelven a preguntar al edge en el siguiente clic. Es un compromiso deliberado. Pierdes algo de velocidad en las visitas repetidas y ganas dos cosas: se cuenta cada clic y una edición de destino no se queda atascada en el navegador de alguien. Las páginas intersticiales de enlaces desactivados, caducados o inexistentes también son no-store, para que un enlace que vuelve a la vida no quede tapado por un error cacheado.
Si gestionas tus propias redirecciones, elige el estado a propósito. Nuestra guía 301 vs 302 y la visión general de los tipos de redirección explican cuándo encaja cada uno.
Borrar una redirección cacheada en Chrome
Si un navegador se queda atascado en una 301 antigua, arregla primero el servidor y luego borra la copia del navegador:
- Abre DevTools y cambia a la pestaña Network.
- Marca Preserve log y borra el registro.
- Carga la URL que redirige para que aparezca la petición de redirección.
- Haz clic derecho en esa petición y borra la caché del navegador para ella.
Un hard refresh normal a menudo no basta. Para una comprobación rápida sin tocar tu perfil habitual, carga la URL en una ventana privada o ejecuta curl -I https://your.short/link para ver el estado y las cabeceras reales sin caché de navegador. Si encadenas varias redirecciones, un salto cacheado obsoleto también es una causa clásica de bucles. Consulta cómo arreglar un bucle de redirección.
Lo que cuesta cada decisión
Cada número de arriba es un compromiso que puedes mover.
- Sube el TTL de L1 y ahorras unas lecturas de Redis, al precio de una ventana obsoleta más larga cada vez que se pierde un mensaje de invalidación. Encontramos pocos motivos para hacerlo.
- Sube el TTL de L2 y el origen ve menos tráfico, pero una purga perdida tarda más en curarse. Cinco minutos fueron nuestro compromiso.
- Prescinde de L2 y cada nodo edge necesita más capacidad de origen, ya que no se comparte nada entre procesos.
- Deja que los navegadores cacheen (301 sin
no-store) y descargas tráfico repetido, pero pierdes recuentos de clics precisos y la capacidad de cambiar de opinión.
Una caché de dos niveles con purga al escribir encaja cuando las lecturas dominan a las escrituras, la distribución de claves está sesgada y unos minutos de obsolescencia son aceptables en el raro caso de que se pierda una purga. Encaja mal cuando los destinos cambian a menudo y deben cambiar al instante, o cuando cada petición es única.
Observarla desde fuera
No puedes ver nuestros contadores de caché, pero sí sus efectos. Una sonda sintética que registre la latencia y el estado de las redirecciones mostrará una primera petición lenta tras un despliegue y una latencia plana después. El panel de latencia de redirección en Datadog recorre esa configuración, y la ingestión de clics fire-and-forget cubre lo que ocurre con cada clic después de servir la redirección.
Si quieres enlaces cortos de marca en tu propio dominio con este comportamiento resuelto, los dominios personalizados son el punto de partida, y la página de precios muestra qué plan incluye cuántos dominios.
Relacionado en el blog
- Presupuesto de latencia: cómo Elido apunta a un p95 bajo 15 ms - el cornerstone para el cluster de ingeniería.
- Redirecciones 301 vs 302: cuál deben usar los enlaces cortos - qué estado enviar y qué significa para los navegadores y la búsqueda.
- Tipos de redirecciones URL: 301, 302, 307, 308 y más - la lista completa de códigos 3xx y cuándo se aplica cada uno.
- Bucle de redirección: cómo encontrar y arreglar ERR_TOO_MANY_REDIRECTS - los saltos cacheados son un culpable habitual.
- Cadenas de redirecciones y SEO: ¿cuántos saltos son demasiados? - lo que cuestan los saltos adicionales.
- Ingesta de clics fire-and-forget: analítica fuera del hot path - lo que ocurre con cada clic después de la redirección.
Preguntas frecuentes
¿Los navegadores cachean las redirecciones 301?
Sí, y de forma agresiva. Una 301 sin cabeceras de caché es cacheable, y algunos navegadores la conservan sin caducidad, de modo que el navegador puede seguir saltando al destino antiguo después de que lo cambies en el servidor. Una cabecera Cache-Control con no-store o un max-age corto lo evita.
¿Se cachean las redirecciones 302?
No por defecto. Una 302 es temporal, así que los navegadores solo la reutilizan cuando una cabecera Cache-Control o Expires dice que sigue vigente. Por eso una 302 es la opción más segura mientras aún pruebas una redirección.
¿Cómo borro una redirección cacheada en Chrome?
Arregla primero el servidor, luego abre DevTools, ve a la pestaña Network, marca Preserve log, carga la URL que redirige y borra la caché de esa petición. Un hard refresh normal suele dejar la redirección cacheada. Probar en una ventana privada es la comprobación rápida.
¿Cuánto debe durar el TTL de la caché de redirecciones?
Tanto como puedas tolerar un destino obsoleto si alguna vez se pierde una purga. Nosotros usamos 60 segundos en proceso y 5 minutos en la caché compartida, y cada edición purga ambas, así que un cambio normalmente se ve en uno o dos segundos. Los TTL son el plan de reserva: si la purga falla, una edición puede tardar hasta unos seis minutos en verse para todos.
¿Por qué mi enlace corto sigue yendo a la URL antigua después de editarlo?
En Elido, una edición purga las copias del edge en uno o dos segundos, así que después la causa habitual es tu navegador o una redirección delante de Elido que guardó una 301 anterior. Comprueba con curl -I la respuesta real y prueba después en una ventana privada para descartar el navegador.
¿Elido permite que los navegadores cacheen sus redirecciones?
No. La respuesta de redirección lleva Cache-Control private, max-age=0, no-store, incluso en enlaces configurados como 301. Cada clic llega al edge, lo que mantiene honestos los recuentos de clics y permite cambiar un destino sin esperar a los navegadores.
Prueba Elido
Pega una URL, obtén un enlace corto
Sin registro. El enlace vive 30 días. Crea una cuenta para conservarlo.
Se necesita una cuenta gratuita. El plan gratuito incluye 25 enlaces en total. ¿Ya tienes una cuenta? Iniciar sesión