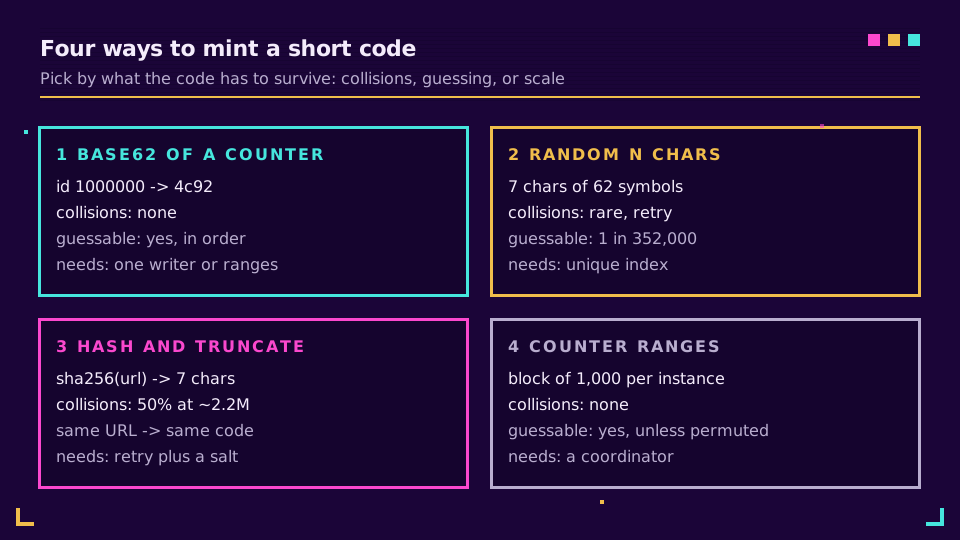
Generowanie krótkich kodów sprowadza się do czterech opcji: zakodować unikalny licznik w base62, wylosować znaki, obciąć hash adresu URL albo rozdawać zakresy identyfikatorów z koordynatora. Liczniki nigdy się nie zderzają, ale dają się odgadnąć. Kody losowe nie dają się odgadnąć, ale potrzebują ścieżki ponawiania. Hash z obcięciem jest najsłabszy z czterech, bo zderza się szybciej, niż ludzie oczekują, i nie daje nic, czego nie dają pozostałe.
Liczby rozstrzygają większość, więc ten wpis je przepracowuje. 7-znakowy kod base62 ma dokładnie 3 521 614 606 208 wartości, a losowy ma 50% szansy na co najmniej jedną kolizję po mniej więcej 2,2 miliona linków. Pierwszy fakt sprawia, że 7 znaków wydaje się ogromne. Drugi to granica urodzin i dlatego "biliony możliwości" nie znaczą "brak kolizji".
Jeśli chcesz całego systemu wokół kodu (przechowywanie, przekierowania, buforowanie), zacznij od jak zbudować skracacz URL. To przybliżenie jednej decyzji z tego przewodnika: skąd bierze się krótki kod.
Kodowanie base62 identyfikatora z autoinkrementacją
Kodowanie base62 zamienia liczbę na ciąg złożony z 62 symboli 0-9, a-z, A-Z. To ten sam pomysł co szesnastkowy z większym alfabetem i to najkrótsza bezpieczna dla URL postać tekstowa liczby całkowitej bez znaków interpunkcyjnych. Identyfikator 125 staje się 21 (2 x 62 + 1), a 1,000,000 staje się 4c92.
const ALPHABET =
  "0123456789abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ";

export function encode(id: bigint): string {
  if (id === 0n) return ALPHABET[0];
  let out = "";
  while (id > 0n) {
    out = ALPHABET[Number(id % 62n)] + out;
    id /= 62n;
  }
  return out;
}

export function decode(code: string): bigint {
  let id = 0n;
  for (const ch of code) id = id * 62n + BigInt(ALPHABET.indexOf(ch));
  return id;
}
Siłą jest to, że unikalność jest dziedziczona z bazy danych. Wiersz 41 000 000 dostaje jeden kod i nikt inny nigdy go nie dostanie. Nie ma pętli ponawiania ani wyszukiwania przed wstawieniem. Kody też rosną powoli: identyfikatory poniżej 62^6 dają kody o sześciu znakach lub mniej, a pierwszy 7-znakowy kod pojawia się przy identyfikatorze 56 800 235 584.
Słabością jest ekspozycja. Kod to numer wiersza w przebraniu, więc decode("4c92") zwraca 1000000. Każdy może policzyć Twoje linki, oszacować Twój wzrost z dwóch próbek oddalonych o tydzień i iterować po każdym kodzie po kolei. W narzędziu wewnętrznym to w porządku. W publicznym skracaczu to darmowe API do zbierania danych, co ma znaczenie dla ryzyk otwartych przekierowań i wyliczania opisanych gdzie indziej na tym blogu.
Kolejność możesz ukryć bez utraty unikalności, przepuszczając identyfikator przez odwracalną permutację (zwykłym wyborem jest mała sieć Feistela) przed kodowaniem. Uważaj na skróty. Mnożenie przez stałą modulo 62^7 wygląda na pomieszane, ale ostatnia cyfra nadal rośnie, co pokazuje szybki test. Pomieszany licznik to zaciemnienie, a nie tajność.
Kody losowe: przestrzeń kluczy, ponawianie i granica urodzin
Losowy krótki kod losuje każdy znak niezależnie z alfabetu. Użyj źródła kryptograficznego i nieobciążonego wyboru. randomInt(62) w Node robi za Ciebie próbkowanie z odrzucaniem, podczas gdy byte % 62 zniekształca rozkład, bo 256 nie jest wielokrotnością 62.
import { randomInt } from "node:crypto";

export function randomCode(length = 7): string {
  let out = "";
  for (let i = 0; i < length; i++) out += ALPHABET[randomInt(62)];
  return out;
}
Jak długi powinien być kod? Przestrzeń kluczy to 62^długość, a problem urodzin mówi, że wśród n losowych losowań z N wartości szansa na co najmniej jedno powtórzenie wynosi około 1 - e^(-n²/2N). Osiąga 50% przy mniej więcej sqrt(2N ln 2) losowaniach. Problem urodzin jest sprzeczny z intuicją, bo pary rosną z kwadratem n.
| Długość | Przestrzeń kluczy (62^L) | Losowe kody do 50% szansy na powtórzenie | Szansa, że nowe wstawienie zderzy się przy 100M linków |
|---|---|---|---|
| 6 | 56,800,235,584 | około 280,600 | 1 na 568 (0,18%) |
| 7 | 3,521,614,606,208 | około 2,209,500 | 1 na 35,216 (0,0028%) |
| 8 | 218,340,105,584,896 | około 17,397,800 | 1 na 2,183,401 (0,000046%) |
Ostatnia kolumna to liczba, która ma znaczenie operacyjne. Powtórzenie wśród wszystkich Twoich linków jest przy skali niemal pewne, ale to, czego Twój kod faktycznie doświadcza, to pojedyncze wstawienie trafiające w zajęte miejsce, a ta szansa to po prostu linki / przestrzeń kluczy. Przy 100 milionach linków i 7 znakach zderza się jedno wstawienie na około 35 000. Zobaczysz to na produkcji, więc potrzebujesz ścieżki ponawiania, ale jest tania.
Obsługa kolizji: niech decyduje baza danych
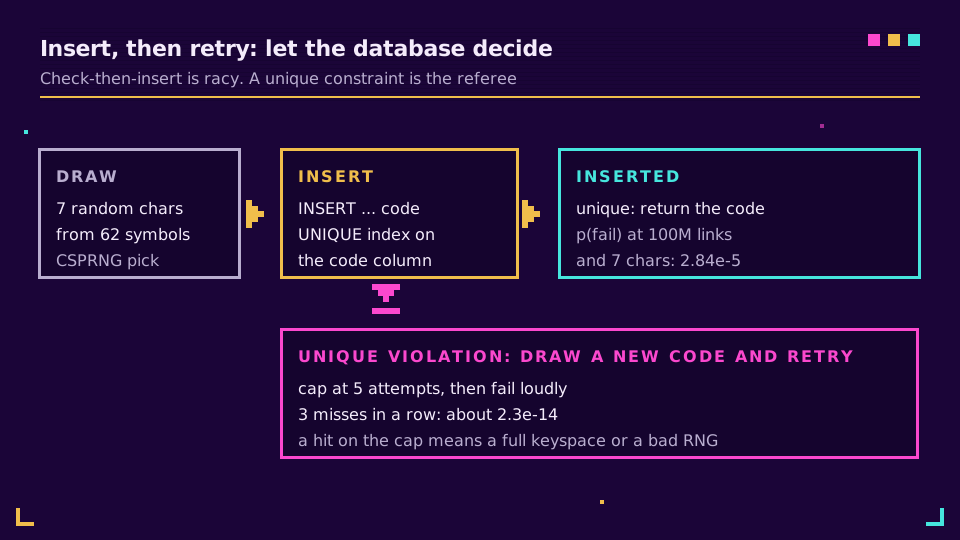
Wzorzec, który działa, to wstaw-a-potem-ponów, a nie sprawdź-a-potem-wstaw. Dwa żądania mogą oba sprawdzić, że aB3x9Qz jest wolne, a potem oba je zapisać. Ograniczenie unikalności na kolumnie kodu zamyka ten wyścig, a nieudane wstawienie to sygnał do ponownego losowania.
export async function createWithRetry(
  tryInsert: (code: string) => Promise<boolean>, // false = unique violation
  attempts = 5,
): Promise<string> {
  for (let i = 0; i < attempts; i++) {
    const code = randomCode();
    if (await tryInsert(code)) return code;
  }
  throw new Error("could not allocate a short code");
}
Tu tryInsert wykonuje Twój INSERT i zwraca false tylko przy błędzie naruszenia unikalności, nigdy przy innych awariach. Jeśli pojedyncze wstawienie zderza się z prawdopodobieństwem p, wszystkie próby zawodzą z prawdopodobieństwem p^próby. W punkcie 100M linków i 7 znaków p wynosi 2,84 x 10^-5, więc trzy porażki z rzędu to około 2,3 x 10^-14. Ogranicz próby mimo to. Jeśli kiedykolwiek zobaczysz osiągnięcie limitu, przestrzeń kluczy jest niemal pełna lub źródło losowości jest zepsute, a głośny błąd bije nieskończoną pętlę.
Ta sama dyscyplina dotyczy idempotentności na punkcie końcowym tworzenia, bo ponowione żądanie HTTP nie może wybić drugiego linku. Limity żądań i idempotentność omawia tę drugą połowę.
Hash z obcięciem: dlaczego zderza się szybciej, niż myślisz
Haszowanie adresu URL wygląda atrakcyjnie, bo jest deterministyczne: ten sam adres URL zawsze daje ten sam kod, więc możesz pominąć wyszukiwanie duplikatów. Kosztem jest to, że kod ma tylko tyle bitów do wydania. Wzięcie 32 bitów digestu daje 2^32 = 4 294 967 296 wartości, a punkt 50% kolizji to około 77 163 adresów URL. Nie miliardy. 7-znakowy wycinek base62 (około 41,7 bitu) przesuwa to do około 2,2 miliona, czyli tyle samo co dla losowego 7-znakowego kodu.
import { createHash } from "node:crypto";

export function hashCode(url: string, length = 7): string {
  const digest = createHash("sha256").update(url).digest();
  const n = digest.readBigUInt64BE(0) % 62n ** BigInt(length);
  return encode(n).padStart(length, "0");
}
Obcięcie więc nie psuje hasha. SHA-256 jest w porządku. Odporność na kolizje pełnych 256 bitów po prostu nie przeżywa przycięcia do 41 bitów. Dziedziczysz zachowanie kodu losowego, więc nadal potrzebujesz ścieżki ponawiania oraz reguły, co zrobić przy zderzeniu (dodać sól i zahaszować ponownie). A determinizm działa przeciwko Tobie: dwóch klientów skracających ten sam adres URL dostaje ten sam kod, a więc ten sam strumień kliknięć, chyba że domieszasz identyfikator konta. Pominąłbym hash z obcięciem w niemal każdym przypadku. Jeśli chcesz deduplikacji, wyszukuj adres URL po kolumnie hasha i kod i tak generuj inaczej.
Zakresy liczników i identyfikatory w stylu Snowflake
Pojedyncza kolumna z autoinkrementacją staje się wąskim gardłem, gdy kilku zapisujących w kilku regionach potrzebuje identyfikatorów. Dwa wzorce tego unikają bez rezygnacji z unikalności.
Pierwszy to zakresy liczników. Koordynator daje każdej instancji aplikacji blok, powiedzmy 1000 identyfikatorów, a instancja koduje je lokalnie bez rundy sieciowej na link. Jeśli instancja umrze, jej niewykorzystany blok jest po prostu pomijany. Dziury w przestrzeni kodów liczącej biliony są nieszkodliwe.
Drugi to identyfikator w stylu Snowflake: znacznik czasu, identyfikator maszyny i sekwencja na milisekundę upakowane w 64 bitach. Sortują się według czasu utworzenia i nie potrzebują koordynatora. Haczyk dla krótkich linków to długość. Wartość 64-bitowa to do 18 446 744 073 709 551 615, a ponieważ 62^10 = 839 299 365 868 340 224 jest mniejsze niż 2^64, potrzebuje do 11 znaków base62. To niezbyt krótko. Identyfikatory Snowflake lepiej pasują do kluczy bazy danych niż do kodów publicznych, więc większość skracaczy trzyma je wewnętrznie i używa osobnego, krótszego kodu.
Oba dziedziczą problem odgadywalności sekwencyjnej, bo oba są uporządkowane z konstrukcji. Owiń je permutacją albo użyj jednego z nich tylko jako wewnętrznego klucza głównego.
Kody własne i słowa zastrzeżone
Sluga własne (vanity) to jedyne miejsce, w którym człowiek wybiera kod, i przechodzą przez to samo ograniczenie unikalności co wszystko inne. Dodatkowa praca to walidacja przed wstawieniem. Własny back-half, taki jak /spring-sale, trzeba sprawdzić pod trzema kątami.
- Słowa zastrzeżone. Ścieżki, których już używa Twoja aplikacja lub sieć, nigdy nie mogą dać się zająć:
api,admin,login,static,robots.txt,favicon.icoi.well-known. Skracacz, który pozwala komuś zarejestrować/login, zbudował generator stron phishingowych. - Kolizje z kodami generowanymi. Jeśli użytkownik zajmie
/aB3x9Qz, Twój generator losowy może później wytworzyć ten sam ciąg. Ograniczenie unikalności to obsługuje, o ile kody własne i generowane dzielą jedną przestrzeń nazw. - Wielkość liter i znaki łudząco podobne. Base62 rozróżnia wielkość liter, więc
/Abi/abto różne linki. Zdecyduj, czy slugi własne porównujesz bez uwzględniania wielkości liter, i rozważ blokowanie par różniących się tylko0/Olubl/1. Stronę brandingu omawia przewodnik po vanity URL.
Losowe 7-znakowe kody mogą też ułożyć się w coś niefortunnego. Przepuszczaj generowane kody przez krótką listę blokującą i losuj ponownie przy trafieniu. Kosztuje to prawie nic.
Wyliczanie, odgadywalność i prywatność
Krótki kod to adres. Nie jest sekretem i żadna długość go nim nie zrobi. Mimo to różnica między sekwencyjnym a losowym jest duża. Przy kodach sekwencyjnych każdy strzał trafia w działający link. Przy 10 milionach linków rozłożonych losowo na 62^7 wartości ślepy strzał trafia w jeden z prawdopodobieństwem 10 000 000 / 3 521 614 606 208, około 1 na 352 000. Skaner potrzebuje setek tysięcy żądań na jedno znalezisko, co ograniczanie żądań i wykrywanie botów mogą ukarać.
Jeśli cel musi pozostać prywatny, kod musi być uprawnieniem (capability). To oznacza co najmniej 128 bitów losowości, czyli w base62 22 znaki (62^22 to około 2^131; 21 znaków daje tylko około 2^125). Potrzebuje też prawdziwej kontroli dostępu za sobą. Wytyczne OWASP dotyczące niebezpiecznych bezpośrednich odwołań do obiektów mówią to samo: nieprzewidywalne identyfikatory pomagają, ale kontrolą jest autoryzacja. Linki chronione hasłem lub wygasające są na przypadki, gdy wyciek kodu zaszkodziłby. Lista kontrolna bezpieczeństwa skracacza URL wymienia kontrole do połączenia z tym, a mechanika działania skracaczy wyjaśnia, dlaczego sam kod nigdy nie może nieść zaufania.
Źródło losowości ma znaczenie z tego samego powodu. Generator z ziarnem, niekryptograficzny, można przewidzieć z kilku wyników, więc użyj CSPRNG platformy, jak w powyższym fragmencie. Jako gotowe alternatywy nanoid implementuje podejście nieobciążonego wyboru z konfigurowalnym alfabetem i długością.
Które podejście wybrać
Wybieraj według tego, co kod musi przetrwać.
- Narzędzie wewnętrzne, mały wolumen: base62 identyfikatora z autoinkrementacją. Proste, bez kolizji, a odgadywalność nie ma znaczenia.
- Publiczny skracacz, jedna baza danych: losowe 7-znakowe kody z wstaw-i-ponów. Tu bym zaczął. Tabela powyżej pokazuje, że szanse kolizji pozostają maleńkie przez lata, a przejście później na 8 znaków to zmiana w jednej linijce, która zachowuje ważność każdego istniejącego linku.
- Zapisy w wielu regionach: zakresy liczników lub identyfikatory Snowflake jako klucz wewnętrzny, plus permutacja lub kod losowy dla tego, co widzi publiczność.
- Hash z obcięciem: tylko jeśli potrzebujesz kodów deterministycznych, a wtedy traktuj go jako kod losowy z gorszą historią ponawiania.
Cokolwiek wybierzesz, przechowuj kod w kolumnie z indeksem unikalnym i trzymaj generowanie poza ścieżką przekierowania, gdzie prawdziwą pracę wykonuje dwupoziomowy cache (opis p95 opóźnienia pokazuje, jak wygląda ta ścieżka po dostrojeniu). Jeśli wolisz nie posiadać generowania kodów, obsługi kolizji i list słów zastrzeżonych, API Elido przyjmuje cel i zwraca krótki link, z walidacją własnych back-halfów po naszej stronie. Zobacz plany, gdy zechcesz to wypróbować.
Powiązane na blogu
- Jak zbudować skracacz URL - pełna architektura, którą ten wpis przybliża.
- Jak działają skracacze URL - podstawowe wprowadzenie koncepcyjne.
- Czym jest własny back-half? - wybierana przez człowieka połowa przestrzeni kodów.
- Strategia cache dla przekierowań URL - co dzieje się po powstaniu kodu.
- Luki otwartych przekierowań - dlaczego kod powinien mapować na zapisany cel.
- Lista kontrolna bezpieczeństwa skracacza URL
Najczęściej zadawane pytania
Czym jest kodowanie base62 w skracaczu URL?
Kodowanie base62 zapisuje liczbę za pomocą 62 symboli: 0-9, a-z i A-Z. Skracacz URL bierze unikalną liczbę całkowitą, zwykle identyfikator z bazy danych, i zamienia ją na zwarty ciąg, taki jak 1Ly7. Ponieważ każda liczba całkowita jest unikalna, każdy kod base62 jest unikalny, więc nie ma kolizji do obsługi.
Ile adresów URL pomieści 7-znakowy krótki kod?
7-znakowy kod base62 ma 62^7 = 3 521 614 606 208 możliwych wartości, około 3,5 biliona. Przy 1000 nowych linków na sekundę wyczerpanie zajmuje około 111 lat, jeśli przypisujesz kody sekwencyjnie. Kody losowe trafiają na pierwsze kolizje znacznie wcześniej, około 2,2 miliona linków dla 50% szansy na co najmniej jedną.
Czy haszowanie adresu URL to dobry sposób generowania krótkiego kodu?
Zwykle nie. Obcięcie skrótu, takiego jak SHA-256, do krótkiego kodu wyrzuca większość digestu, więc różne adresy URL w końcu się zderzają, a i tak potrzebujesz logiki ponawiania. Identyczne adresy URL mapują się też na ten sam kod, co uniemożliwia dawanie dwóm użytkownikom osobnych linków z osobną analityką.
Jak uniknąć kolizji przy generowaniu krótkich adresów URL?
Albo uniemożliwić kolizje, albo uczynić je odwracalnymi. Zakodowanie unikalnego licznika w base62 nie może się zderzyć. Dla kodów losowych lub haszowanych wstawiaj z ograniczeniem unikalności na kolumnie kodu i ponawiaj ze świeżym kodem, gdy wstawienie się nie powiedzie. Sprawdź-a-potem-wstaw jest podatne na wyścig; pozwól decydować bazie danych.
Czy ktoś może zgadnąć lub wyliczyć krótkie linki?
Tak, jeśli kody są sekwencyjne. Każdy może przejść /1, /2, /3 i odczytać każdy cel. Losowe 7-znakowe kody sprawiają, że ślepy strzał trafia w działający link mniej więcej raz na 350 000 prób przy 10 milionach linków, co spowalnia skanery, ale nie czyni linku prywatnym. Traktuj kod jak adres, a nie hasło.
Czy krótkie kody powinny być sekwencyjne, czy losowe?
Używaj kodów losowych dla linków publicznych, a sekwencyjnych identyfikatorów tylko wewnętrznie. Kody sekwencyjne są krótkie i wolne od kolizji, ale ujawniają, ile linków istnieje, i pozwalają konkurentom je zbierać. Kod losowy kosztuje Cię w rzadkich przypadkach jedno ponowienie przy ograniczeniu unikalności i usuwa problem wyliczania.
Wypróbuj Elido
Wklej URL, otrzymaj krótki link
Bez rejestracji. Link działa 30 dni. Zarejestruj się, aby zachować go na zawsze.
Za darmo, bez rejestracji · 2 dziennie