Cache przekierowań URL to warstwa, która odpowiada na pytanie "dokąd wskazuje ten slug?" bez każdorazowego pytania bazy danych. Nasz ma dwa poziomy przed originem: mały LRU w procesie, który żyje 60 sekund, i współdzielony cache Redis, który żyje 5 minut. Jeśli oba chybią, edge pyta origin i wypełnia oba w drodze powrotnej.
To cały projekt, a liczby ważą więcej niż kształt. Ten wpis omawia poziomy, TTL, których używamy dziś, jak edycja czyści oba poziomy (i co się dzieje, gdy to zawiedzie) oraz drugi cache przekierowań, który ludzie zwykle mają na myśli, szukając tego tematu: ten wewnątrz przeglądarki. Cornerstone o p95 przekierowań opisuje cały budżet latencji. To jest część poświęcona cache.
Pierwszą wersję tego wpisu napisałem z większą pewnością, niż kod na to zasługiwał. Przepisałem go na podstawie faktycznej usługi edge, więc wszystko poniżej opisuje to, co działa teraz, łącznie z częściami, które chcielibyśmy poprawić.
Dlaczego przekierowanie w ogóle potrzebuje cache
Przekierowanie wykonuje jedno wyszukanie: host plus slug na wejściu, adres docelowy i reguły na wyjściu. Nic więcej nie należy do ścieżki żądania. Adres docelowy, status, wygaśnięcie, reguły targetowania i limit kliknięć mieszkają w rekordzie linku, a ten rekord mieszka w Postgresie za API originu.
Wołanie originu przy każdym kliknięciu to opcja powolna i krucha. Każde wywołanie originu dodaje do żądania skok sieciowy, a czkawka bazy danych stałaby się awarią przekierowań. Dlatego edge trzyma niedawne rekordy blisko, a origin traktuje jako ostatnią deskę ratunku. Dla użytkownika widocznym efektem jest przekierowanie, które nie zależy od tego, czy panel jest zdrowy.
Dwa poziomy, z prawdziwymi liczbami
Każde wyszukanie przebiega w tej kolejności, z kluczem host/slug:
- L1, w procesie. Wygasający LRU przechowujący do 100 000 rekordów linków, każdy przez 60 sekund. Używa
expirableLRU z hashicorp/golang-lru. Trafienie nie kosztuje żadnej sieci. - L2, Redis. Jeden współdzielony cache dla wszystkich procesów edge, z rekordami zapisanymi jako JSON pod prefiksem
elido:link:na 5 minut. Trafienie w L2 uzupełnia także L1. - Origin. API linków przez gRPC lub HTTP. To jedyna warstwa, która może powiedzieć "ten link nie istnieje". Trafienie tutaj wypełnia oba cache.

Łatwo przeoczyć dwa szczegóły. Po pierwsze, błąd Redisa jest traktowany dokładnie jak chybienie, więc awaria Redisa spowalnia przekierowania, zamiast je psuć. Po drugie, odpowiedź "nie znaleziono" z originu nie jest cache'owana. Literówki i skanery sprawdzające losowe sluge'i trafiają do originu za każdym razem. To znana luka i pierwsza rzecz, którą bym naprawił, gdyby ruch sondujący kiedykolwiek miał znaczenie.
Dziś nie łączymy też równoczesnych chybień. Jeśli zimny link dostanie serię kliknięć w tej samej chwili, każde z nich może dotrzeć do originu. Nie zaszkodziło nam to, ale to ograniczenie, które warto znać, zanim skopiujesz ten projekt.
Dlaczego L1 to tylko 60 sekund
Cache w procesie nie może być współdzielony, więc każdy proces edge trzyma własną kopię. Aby wyczyścić go z zewnątrz, każdy proces edge w tle subskrybuje kanał pub/sub Redisa i porzuca klucz, gdy nadejdzie wiadomość o unieważnieniu. TTL 60 sekund to siatka bezpieczeństwa za tym mechanizmem: na tyle krótkie, żeby pominięta wiadomość szybko się zagoiła, i na tyle długie, żeby link z równym ruchem był serwowany z pamięci niemal za każdym razem.
To samo rozumowanie wyjaśnia limit rozmiaru. 100 000 wpisów pokrywa gorący zbiór roboczy, bo ruch przekierowań jest silnie skośny. Mały odsetek slugów dostaje większość kliknięć, a reszta może spaść do L2 bez niczyjej wiedzy.
Jeśli dobierasz rozmiar u siebie, zacznij od TTL. Wybierz nieaktualność, którą możesz obronić przed klientem, a potem policz wstecz, jaki współczynnik trafień ci to daje.
Jak edycje docierają do edge'a
Gdy ktoś edytuje link, najpierw aktualizuje się Postgres. Zaraz po zapisaniu zapisu api-core usuwa klucz linku w Redisie i publikuje wiadomość o unieważnieniu na elido:link:invalidate. Każdy proces edge nasłuchuje i porzuca swoją kopię w pamięci. Następne kliknięcie chybia oba poziomy i ładuje nowy rekord z origin. Odwiedzający widzą zmianę w ciągu sekundy lub dwóch.
Czyszczenie obejmuje więcej niż adres docelowy: reguły kierowania, hasło, wygaśnięcie, limit kliknięć, status, typ przekierowania, zmianę sluga (czyszczone są oba krótkie adresy, stary i nowy, więc stary od razu przestaje się rozwiązywać), usunięcia, przywrócenia z kosza, zbiorcze zmiany statusu, warianty A/B, nowy werdykt skanera, dołączenie nakładki CTA i rotację szyfrowania. Nie ma żadnego ustawienia; dostaje to każdy plan.
Jeden wyścig wymagał drugiego przebiegu. Wyszukiwanie, które zaczęło się tuż przed zapisem, może odczytać stary wiersz i włożyć go z powrotem do Redisa po czyszczeniu. Dlatego api-core czyści jeszcze raz, 2 sekundy później, co zamyka to okno.
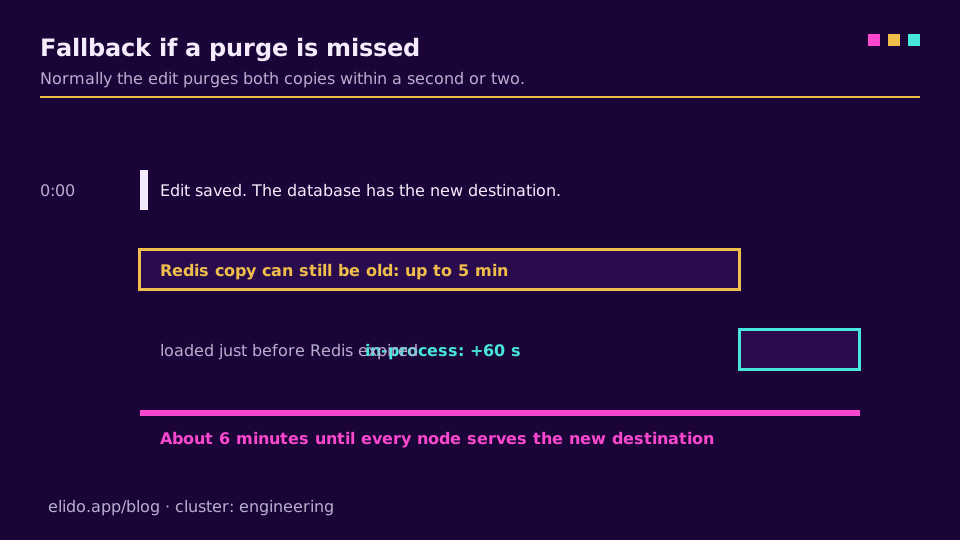
Czyszczenie działa na zasadzie najlepszych starań i nigdy nie leży na ścieżce przekierowania. Jeśli Redis jest na chwilę niedostępny, przejmują je TTL jako rozwiązanie awaryjne, a najgorszy przypadek jest ten stary: L2 może trzymać stary rekord do 5 minut, a proces edge może załadować go do L1 tuż przed wygaśnięciem L2 i trzymać kolejne 60 sekund, łącznie mniej więcej sześć minut.
Nie wszystko jest czyszczone per link. Zmiany na poziomie workspace'u, takie jak piksele, branding, edycje treści nakładki CTA i ustawienia całej domeny, nadal podlegają zwykłym TTL, chyba że działanie admina już je wyczyściło.
Przy premierze lub wycofaniu oznacza to, że możesz zmienić adres docelowy dokładnie w chwili, gdy go potrzebujesz, i sprawdzić go curl -I kilka sekund później. Zanim czyszczenie istniało, rada tutaj brzmiała: zaplanuj zmiany sześć minut wcześniej. Już tego nie potrzebujesz.
Rozgrzewanie cache i zimne starty
Niczego nie rozgrzewamy wstępnie. Świeży Redis zaczyna pusty i wypełnia się w miarę klikania w linki. Świeżo uruchomiony proces edge zaczyna z pustym L1 i dla pierwszych żądań spada do Redisa, a potem wypełnia się w miarę używania linków.
To nudne celowo. Ponieważ każda warstwa działa w trybie best-effort, a origin jest wiążący, zimny cache kosztuje latencję pierwszego kliknięcia w dany link, nigdy poprawność. Jeśli ktoś mówi ci, że potrzebujesz przycisku rozgrzewania, najpierw zapytaj, jaka jest faktyczna latencja zimnego kliknięcia. Przy większości obciążeń nikt jej nie widzi.
Drugi cache przekierowań: Twoja przeglądarka
Większość wyszukiwań "cache przekierowań" dotyczy zupełnie innego cache, który powoduje więcej zgłoszeń do wsparcia niż nasz. Przeglądarki cache'ują odpowiedzi przekierowań, a kod statusu decyduje, jak mocno.
301 to "stałe". Specyfikacja cache HTTP (RFC 9111) traktuje je domyślnie jako nadające się do cache, a przeglądarki historycznie zapisywały je bez terminu ważności, gdy żaden nagłówek nie mówi inaczej. Wpis Rowana Collinsa opisuje klasyczną pułapkę: przekierowanie trafia do cache, adres jest potem użyty ponownie, a odwiedzający ze starą kopią odbijają się bez końca. 302 lub 307 są używane ponownie tylko wtedy, gdy zezwala na to nagłówek świeżości. Przewodnik MDN o cache to najjaśniejsze źródło o odpowiednich nagłówkach: max-age ustawia świeżość, private ogranicza przechowywanie do przeglądarki, a no-store w ogóle zatrzymuje zapis.
Nasze odpowiedzi przekierowań wysyłają Cache-Control: private, max-age=0, no-store, niezależnie od tego, czy link używa 301, 302 czy 307. Przeglądarki pytają więc edge'a ponownie przy następnym kliknięciu. To świadomy kompromis. Tracisz trochę szybkości przy powtórnych wizytach, a zyskujesz dwie rzeczy: każde kliknięcie jest policzone, a edycja adresu docelowego nie utknie w czyjejś przeglądarce. Strony pośrednie dla wyłączonych, wygasłych lub brakujących linków też mają no-store, więc link, który wraca do życia, nie jest maskowany przez cache'owany błąd.
Jeśli prowadzisz własne przekierowania, wybieraj status świadomie. Nasz przewodnik o 301 kontra 302 i przegląd typów przekierowań opisują, kiedy pasuje który.
Czyszczenie cache'owanego przekierowania w Chrome
Jeśli przeglądarka utknęła na starym 301, najpierw napraw serwer, a potem wyczyść kopię w przeglądarce:
- Otwórz DevTools i przełącz się na kartę Network.
- Zaznacz Preserve log i wyczyść log.
- Wczytaj przekierowujący adres URL, żeby żądanie przekierowania się pojawiło.
- Kliknij to żądanie prawym przyciskiem i wyczyść dla niego cache przeglądarki.
Zwykłe twarde odświeżenie często nie wystarczy. Do szybkiego sprawdzenia bez ruszania zwykłego profilu wczytaj adres w oknie prywatnym albo uruchom curl -I https://your.short/link, aby zobaczyć prawdziwy status i nagłówki bez udziału cache przeglądarki. Jeśli łańcuchujesz kilka przekierowań, nieaktualny cache'owany skok jest też klasyczną przyczyną pętli. Zobacz jak naprawić pętlę przekierowań.
Ile kosztuje każdy wybór
Każda liczba powyżej to kompromis, który możesz przesunąć.
- Podnieś TTL L1, a zaoszczędzisz kilka odczytów z Redisa, kosztem dłuższego okna nieaktualności za każdym razem, gdy wiadomość o unieważnieniu zostanie pominięta. Znaleźliśmy niewiele powodów, żeby to robić.
- Podnieś TTL L2, a origin zobaczy mniej ruchu, ale pominięte czyszczenie będzie się goić dłużej. Pięć minut było naszym kompromisem.
- Pomiń L2, a każdy węzeł edge potrzebuje większej przepustowości originu, bo nic nie jest współdzielone między procesami.
- Pozwól przeglądarkom cache'ować (301 bez
no-store), a zrzucisz powtórny ruch, ale stracisz dokładne liczniki kliknięć i możliwość zmiany zdania.
Dwupoziomowy cache z czyszczeniem przy zapisie pasuje, gdy odczyty przeważają nad zapisami, rozkład kluczy jest skośny, a kilka minut nieaktualności jest akceptowalne w rzadkim przypadku utraty czyszczenia. Pasuje słabo, gdy adresy docelowe zmieniają się często i muszą zmieniać się natychmiast albo gdy każde żądanie jest unikalne.
Obserwacja z zewnątrz
Liczników naszego cache nie zobaczysz, ale zobaczysz jego skutki. Syntetyczna sonda zapisująca latencję i status przekierowań pokaże wolne pierwsze żądanie po wdrożeniu i płaską latencję potem. Dashboard latencji przekierowań w Datadog opisuje taką konfigurację, a wpis o przyjmowaniu kliknięć fire-and-forget mówi, co dzieje się z każdym kliknięciem po obsłużeniu przekierowania.
Jeśli chcesz mieć brandowane krótkie linki na własnej domenie z tym zachowaniem załatwionym za Ciebie, zacznij od własnych domen, a strona z cennikiem pokazuje, który plan obejmuje ile domen.
Powiązane na blogu
- Osiąganie p95 poniżej 15 ms dla przekierowań - cornerstone klastra inżynieryjnego.
- Przekierowania 301 a 302 - który status wysłać i co oznacza dla przeglądarek i wyszukiwarek.
- Typy przekierowań - pełna lista kodów 3xx i kiedy który ma zastosowanie.
- Jak naprawić pętlę przekierowań - cache'owane skoki to częsty winowajca.
- Łańcuchy przekierowań a SEO - ile kosztują dodatkowe skoki.
- Przyjmowanie kliknięć fire-and-forget - co dzieje się z każdym kliknięciem po przekierowaniu.
Najczęściej zadawane pytania
Czy przeglądarki cache'ują przekierowania 301?
Tak, i to agresywnie. Przekierowanie 301 bez nagłówków cache nadaje się do zapisania w pamięci podręcznej, a niektóre przeglądarki trzymają je bez terminu ważności, więc po zmianie celu po stronie serwera przeglądarka może dalej skakać pod stary adres. Powstrzymuje to nagłówek Cache-Control z no-store lub krótkim max-age.
Czy przekierowania 302 są cache'owane?
Domyślnie nie. 302 jest tymczasowe, więc przeglądarki używają go ponownie tylko wtedy, gdy nagłówek Cache-Control lub Expires mówi, że jest świeże. Dlatego 302 to bezpieczniejszy wybór, gdy dopiero testujesz przekierowanie.
Jak wyczyścić cache'owane przekierowanie w Chrome?
Najpierw napraw serwer, potem otwórz DevTools, przejdź do karty Network, zaznacz Preserve log, wczytaj przekierowujący adres URL i wyczyść cache dla tego żądania. Zwykłe twarde odświeżenie często zostawia przekierowanie w cache. Szybkim sprawdzeniem jest test w oknie prywatnym.
Jak długie powinno być TTL cache przekierowań?
Tak długie, jak możesz tolerować nieaktualny adres docelowy, gdy czyszczenie kiedyś zawiedzie. My używamy 60 sekund w procesie i 5 minut we współdzielonym cache, a każda edycja czyści oba, więc zmiana zwykle pojawia się w ciągu sekundy lub dwóch. TTL to rozwiązanie awaryjne: jeśli czyszczenie się nie powiedzie, edycja może potrzebować około sześciu minut, żeby pojawić się u wszystkich.
Dlaczego mój krótki link nadal prowadzi pod stary adres po edycji?
W Elido edycja czyści kopie na edge'u w ciągu sekundy lub dwóch, więc potem zwykle winna jest przeglądarka albo przekierowanie przed Elido, które zapisało wcześniejsze 301. Sprawdź za pomocą curl -I, jaka jest prawdziwa odpowiedź, a potem przetestuj w oknie prywatnym, żeby wykluczyć przeglądarkę.
Czy Elido pozwala przeglądarkom cache'ować swoje przekierowania?
Nie. Odpowiedź przekierowania niesie Cache-Control private, max-age=0, no-store, nawet dla linków ustawionych na 301. Każde kliknięcie dociera do edge'a, dzięki czemu liczba kliknięć jest rzetelna, a adres docelowy można zmienić bez czekania na przeglądarki.
Wypróbuj Elido
Wklej URL, otrzymaj krótki link
Bez rejestracji. Link działa 30 dni. Zarejestruj się, aby zachować go na zawsze.
Wymagane darmowe konto. Darmowy plan zawiera łącznie 25 linków. Masz już konto? Zaloguj się