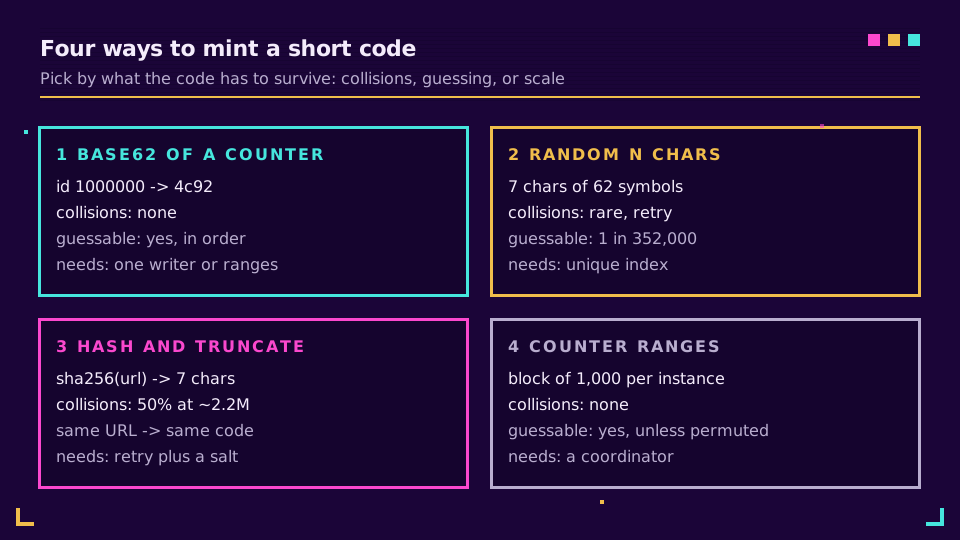
La generazione di short code si riduce a quattro opzioni: codificare in base62 un contatore univoco, estrarre caratteri casuali, troncare un hash dell'URL oppure distribuire intervalli di ID da un coordinatore. I contatori non collidono mai ma sono indovinabili. I codici casuali non sono indovinabili ma richiedono un percorso di retry. Hash e troncamento è la più debole delle quattro, perché collide prima di quanto la gente si aspetti e non ti dà nulla che le altre non diano.
I numeri decidono quasi tutto, quindi questo articolo li affronta. Un codice base62 di 7 caratteri ha esattamente 3.521.614.606.208 valori, e uno casuale ha il 50% di probabilità di almeno una collisione dopo circa 2,2 milioni di link. Il primo fatto fa sembrare enormi i 7 caratteri. Il secondo è il limite del compleanno, ed è il motivo per cui "migliaia di miliardi di possibilità" non significa "nessuna collisione".
Se vuoi l'intero sistema attorno al codice (archiviazione, redirect, caching), parti da come costruire un accorciatore di URL. Questo è l'ingrandimento su una sola decisione di quella guida: da dove viene lo short code.
Codifica base62 di un ID auto-increment
La codifica base62 converte un numero in una stringa sui 62 simboli 0-9, a-z, A-Z. È la stessa idea dell'esadecimale con un alfabeto più grande, ed è la forma testuale più corta e sicura per gli URL di un intero che evita la punteggiatura. L'ID 125 diventa 21 (2 x 62 + 1), e 1.000.000 diventa 4c92.
const ALPHABET =
  "0123456789abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ";

export function encode(id: bigint): string {
  if (id === 0n) return ALPHABET[0];
  let out = "";
  while (id > 0n) {
    out = ALPHABET[Number(id % 62n)] + out;
    id /= 62n;
  }
  return out;
}

export function decode(code: string): bigint {
  let id = 0n;
  for (const ch of code) id = id * 62n + BigInt(ALPHABET.indexOf(ch));
  return id;
}
Il punto di forza è che l'unicità viene ereditata dal database. La riga 41.000.000 riceve un codice e nessun altro lo riceverà mai. Non c'è alcun ciclo di retry né alcuna ricerca prima dell'inserimento. I codici crescono inoltre lentamente: gli ID sotto 62^6 danno codici di sei caratteri o meno, e il primo codice di 7 caratteri compare all'ID 56.800.235.584.
Il punto debole è l'esposizione. Il codice è il numero di riga sotto mentite spoglie, quindi decode("4c92") restituisce 1000000. Chiunque può contare i tuoi link, stimare la tua crescita da due campioni a una settimana di distanza e iterare ogni codice in ordine. Per uno strumento interno va bene. Per un accorciatore pubblico è una API di scraping gratuita, il che conta per i rischi di open redirect ed enumerazione trattati altrove in questo blog.
Puoi nascondere l'ordine senza perdere l'unicità facendo passare l'ID attraverso una permutazione invertibile (una piccola rete di Feistel è la scelta abituale) prima di codificarlo. Fai attenzione alle scorciatoie. Moltiplicare per una costante modulo 62^7 sembra rimescolato ma mantiene l'ultima cifra in incremento, come mostra un test rapido. Un contatore rimescolato è offuscamento, non segretezza.
Codici casuali: spazio delle chiavi, retry e limite del compleanno
Uno short code casuale estrae ogni carattere in modo indipendente dall'alfabeto. Usa una fonte crittografica e una scelta non distorta. randomInt(62) in Node fa il campionamento con rifiuto per te, mentre byte % 62 distorce la distribuzione perché 256 non è un multiplo di 62.
import { randomInt } from "node:crypto";

export function randomCode(length = 7): string {
  let out = "";
  for (let i = 0; i < length; i++) out += ALPHABET[randomInt(62)];
  return out;
}
Quanto deve essere lungo il codice? Lo spazio delle chiavi è 62^lunghezza, e il problema del compleanno dice che tra n estrazioni casuali da N valori, la probabilità di almeno una ripetizione è circa 1 - e^(-n²/2N). Raggiunge il 50% a circa sqrt(2N ln 2) estrazioni. Il problema del compleanno è controintuitivo perché le coppie crescono con il quadrato di n.
| Lunghezza | Spazio delle chiavi (62^L) | Codici casuali fino al 50% di probabilità di una ripetizione | Probabilità che un nuovo inserimento collida con 100M di link |
|---|---|---|---|
| 6 | 56.800.235.584 | circa 280.600 | 1 su 568 (0,18%) |
| 7 | 3.521.614.606.208 | circa 2.209.500 | 1 su 35.216 (0,0028%) |
| 8 | 218.340.105.584.896 | circa 17.397.800 | 1 su 2.183.401 (0,000046%) |
L'ultima colonna è il numero che conta a livello operativo. Una ripetizione tra tutti i tuoi link è quasi certa su larga scala, ma ciò che il tuo codice sperimenta davvero è un singolo inserimento che colpisce uno slot occupato, e quella probabilità è semplicemente link / spazio delle chiavi. Con 100 milioni di link e 7 caratteri, un inserimento su circa 35.000 collide. Lo vedrai in produzione, quindi ti serve un percorso di retry, ma è economico.
Gestione delle collisioni: lascia decidere al database
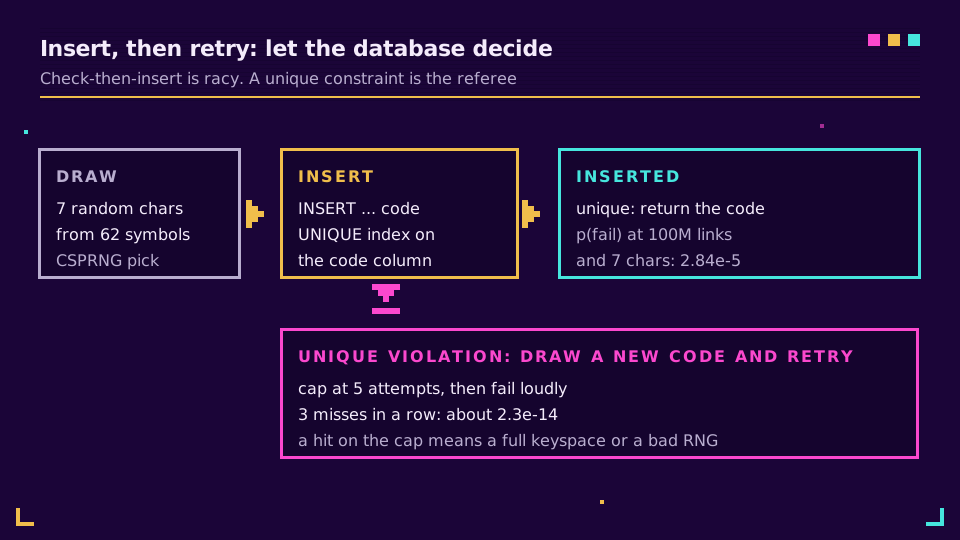
Lo schema che funziona è inserisci-poi-riprova, non verifica-poi-inserisci. Due richieste possono entrambe verificare che aB3x9Qz sia libero e poi scriverlo entrambe. Un vincolo di unicità sulla colonna del codice chiude quella race condition, e l'inserimento fallito è il tuo segnale per estrarre di nuovo.
export async function createWithRetry(
  tryInsert: (code: string) => Promise<boolean>, // false = unique violation
  attempts = 5,
): Promise<string> {
  for (let i = 0; i < attempts; i++) {
    const code = randomCode();
    if (await tryInsert(code)) return code;
  }
  throw new Error("could not allocate a short code");
}
Qui tryInsert esegue la tua INSERT e restituisce false solo per un errore di violazione dell'unicità, mai per altri fallimenti. Se un singolo inserimento collide con probabilità p, tutti i tentativi falliscono con probabilità p^tentativi. Al punto di 100M di link e 7 caratteri, p è 2,84 x 10^-5, quindi tre fallimenti consecutivi sono circa 2,3 x 10^-14. Limita comunque i tentativi. Se vedi mai raggiungere il limite, lo spazio delle chiavi è quasi pieno o la fonte casuale è guasta, e un errore rumoroso batte un ciclo infinito.
La stessa disciplina vale per l'idempotenza sull'endpoint di creazione, perché una richiesta HTTP ripetuta non deve generare un secondo link. Limiti di frequenza e idempotenza copre quella metà.
Hash e troncamento: perché collide prima di quanto pensi
Fare l'hash dell'URL sembra attraente perché è deterministico: lo stesso URL produce sempre lo stesso codice, quindi puoi saltare una ricerca dei duplicati. Il costo è che un codice ha solo un certo numero di bit da spendere. Prendere 32 bit di un digest dà 2^32 = 4.294.967.296 valori, e il punto di collisione al 50% è circa 77.163 URL. Non miliardi. Una porzione base62 di 7 caratteri (circa 41,7 bit) lo spinge a circa 2,2 milioni, che è lo stesso di un codice casuale di 7 caratteri.
import { createHash } from "node:crypto";

export function hashCode(url: string, length = 7): string {
  const digest = createHash("sha256").update(url).digest();
  const n = digest.readBigUInt64BE(0) % 62n ** BigInt(length);
  return encode(n).padStart(length, "0");
}
Quindi il troncamento non rompe l'hash. SHA-256 va benissimo. La resistenza alle collisioni dei 256 bit completi semplicemente non sopravvive al taglio a 41 bit. Erediti il comportamento di un codice casuale, quindi ti serve comunque il percorso di retry, più una regola su cosa fare in caso di scontro (salt e nuovo hash). E il determinismo gioca contro di te: due clienti che accorciano lo stesso URL ottengono lo stesso codice e quindi lo stesso flusso di click, a meno che tu non mescoli un ID account. Salterei hash e troncamento in quasi tutti i casi. Se vuoi la deduplicazione, cerca l'URL tramite una colonna di hash e genera comunque il codice in un altro modo.
Intervalli di contatori e ID in stile Snowflake
Una singola colonna auto-increment diventa un collo di bottiglia quando più scrittori in più regioni hanno bisogno di ID. Due schemi lo evitano senza rinunciare all'unicità.
Il primo sono gli intervalli di contatori. Un coordinatore consegna a ogni istanza dell'applicazione un blocco, diciamo 1.000 ID, e l'istanza li codifica localmente senza un viaggio di andata e ritorno per link. Se un'istanza muore, il suo blocco inutilizzato viene semplicemente saltato. Le lacune in uno spazio di codici di migliaia di miliardi sono innocue.
Il secondo è un ID in stile Snowflake: un timestamp, un ID macchina e una sequenza per millisecondo impacchettati in 64 bit. Questi si ordinano per orario di creazione e non richiedono un coordinatore. Il problema per i link brevi è la lunghezza. Un valore a 64 bit arriva a 18.446.744.073.709.551.615, e poiché 62^10 = 839.299.365.868.340.224 è minore di 2^64, servono fino a 11 caratteri base62. Non è molto breve. Gli ID Snowflake si adattano meglio alle chiavi del database che ai codici pubblici, quindi la maggior parte degli accorciatori li tiene interni e usa un codice separato e più corto.
Entrambi ereditano il problema dell'indovinabilità sequenziale, perché entrambi sono ordinati per costruzione. Avvolgili in una permutazione, oppure usane uno solo come chiave primaria interna.
Codici personalizzati e parole riservate
Gli slug personalizzati sono l'unico punto in cui una persona sceglie il codice, e passano per lo stesso vincolo di unicità di tutto il resto. Il lavoro in più è la validazione prima dell'inserimento. Un back-half personalizzato come /spring-sale va controllato rispetto a tre cose.
- Parole riservate. I percorsi che la tua applicazione o il web già usano non devono mai poter essere rivendicati:
api,admin,login,static,robots.txt,favicon.icoe.well-known. Un accorciatore che permette a qualcuno di registrare/loginha costruito un generatore di pagine di phishing. - Collisioni con i codici generati. Se un utente prende
/aB3x9Qz, il tuo generatore casuale può in seguito produrre la stessa stringa. Il vincolo di unicità se ne occupa, a patto che i codici personalizzati e quelli generati condividano un unico spazio dei nomi. - Maiuscole/minuscole e caratteri simili. Base62 distingue le maiuscole, quindi
/Abe/absono link diversi. Decidi se gli slug personalizzati vengono confrontati senza distinguere le maiuscole, e valuta di bloccare le coppie che differiscono solo per0/Ool/1. La guida agli URL vanity copre il lato del branding.
I codici casuali di 7 caratteri possono anche comporre qualcosa di spiacevole. Fai passare i codici generati attraverso una breve blocklist e riestrai in caso di corrispondenza. Costa quasi nulla.
Enumerazione, indovinabilità e privacy
Uno short code è un indirizzo. Non è un segreto, e nessuna lunghezza lo trasforma in uno. Eppure la differenza tra sequenziale e casuale è grande. Con i codici sequenziali ogni tentativo colpisce un link attivo. Con 10 milioni di link distribuiti a caso su 62^7 valori, un tentativo alla cieca ne colpisce uno con probabilità 10.000.000 / 3.521.614.606.208, circa 1 su 352.000. Uno scanner ha bisogno di centinaia di migliaia di richieste per ogni scoperta, cosa che il rate limiting e il rilevamento dei bot possono punire.
Se una destinazione deve restare privata, il codice deve essere una capability. Significa almeno 128 bit di casualità, che in base62 sono 22 caratteri (62^22 è circa 2^131; 21 caratteri danno solo circa 2^125). Serve anche un vero controllo di accesso dietro di esso. Le indicazioni di OWASP sui riferimenti diretti insicuri agli oggetti fanno la stessa osservazione: gli identificatori imprevedibili aiutano, ma l'autorizzazione è il controllo. I link protetti da password o con scadenza servono per i casi in cui un codice trapelato farebbe danni. La checklist di sicurezza per gli accorciatori di URL elenca i controlli da abbinare, e i meccanismi di funzionamento degli accorciatori spiegano perché il codice da solo non potrà mai portare fiducia.
La fonte della casualità conta per lo stesso motivo. Un generatore con seed e non crittografico può essere previsto da poche uscite, quindi usa il CSPRNG della piattaforma, come nello snippet sopra. Per alternative già pronte, nanoid implementa l'approccio della scelta non distorta con alfabeto e lunghezza configurabili.
Quale approccio scegliere
Scegli in base a ciò che il codice deve sopportare.
- Strumento interno, volume ridotto: base62 di un ID auto-increment. Semplice, senza collisioni, e l'indovinabilità non conta.
- Accorciatore pubblico, un solo database: codici casuali di 7 caratteri con inserisci-e-riprova. Partirei da qui. La tabella sopra mostra che le probabilità di collisione restano minuscole per anni, e passare a 8 caratteri in seguito è una modifica di una riga che mantiene validi tutti i link esistenti.
- Scritture multi-regione: intervalli di contatori o ID Snowflake come chiave interna, più una permutazione o un codice casuale per ciò che vede il pubblico.
- Hash e troncamento: solo se ti servono codici deterministici, e in tal caso trattalo come un codice casuale con una gestione dei retry peggiore.
Qualunque cosa scegli, memorizza il codice in una colonna con indice univoco e tieni la generazione fuori dal percorso del redirect, dove una cache a due livelli fa il lavoro vero (l'approfondimento sulla latenza p95 mostra come appare quel percorso quando è ottimizzato). Se preferisci non occuparti di generazione dei codici, gestione delle collisioni ed elenchi di parole riservate, l'API di Elido prende una destinazione e restituisce un link breve, con i back-half personalizzati validati per te. Vedi i piani quando vuoi provarla.
Correlati sul blog
- Come costruire un accorciatore di URL - l'architettura completa su cui questo articolo si concentra.
- Come funzionano gli accorciatori di URL - l'introduzione concettuale.
- Cos'è un back-half personalizzato? - la metà dello spazio dei codici scelta da una persona.
- Strategia di cache per i redirect degli URL - cosa accade dopo che il codice esiste.
- Vulnerabilità di open redirect - perché il codice dovrebbe corrispondere a una destinazione memorizzata.
- Checklist di sicurezza per gli accorciatori di URL
Domande frequenti
Cos'è la codifica base62 in un accorciatore di URL?
La codifica base62 scrive un numero usando 62 simboli: 0-9, a-z e A-Z. Un accorciatore di URL prende un intero univoco, di solito un ID del database, e lo converte in una stringa compatta come 1Ly7. Poiché ogni intero è univoco, ogni codice base62 è univoco, quindi non ci sono collisioni da gestire.
Quanti URL può contenere uno short code di 7 caratteri?
Un codice base62 di 7 caratteri ha 62^7 = 3.521.614.606.208 valori possibili, circa 3,5 mila miliardi. A 1.000 nuovi link al secondo servono circa 111 anni per esaurirli se assegni i codici in modo sequenziale. I codici casuali incontrano le prime collisioni molto prima, intorno a 2,2 milioni di link per una probabilità del 50% di averne almeno una.
Fare l'hash di un URL è un buon modo per generare uno short code?
Di solito no. Troncare un hash come SHA-256 a un codice breve scarta la maggior parte del digest, quindi URL diversi prima o poi collidono, e ti serve comunque una logica di retry. Inoltre URL identici corrispondono allo stesso codice, il che ti impedisce di dare a due utenti link separati con analytics separati.
Come si evitano le collisioni nella generazione di URL brevi?
O si rendono le collisioni impossibili, oppure si rendono recuperabili. Codificare in base62 un contatore univoco non può collidere. Per i codici casuali o derivati da hash, inserisci con un vincolo di unicità sulla colonna del codice e riprova con un nuovo codice quando l'inserimento fallisce. Verificare e poi inserire è soggetto a race condition; lascia decidere al database.
Qualcuno può indovinare o enumerare i link brevi?
Sì, se i codici sono sequenziali. Chiunque può scorrere /1, /2, /3 e leggere ogni destinazione. I codici casuali di 7 caratteri fanno sì che un tentativo alla cieca colpisca un link attivo circa una volta ogni 350.000 tentativi con 10 milioni di link, il che rallenta gli scanner ma non rende privato un link. Tratta il codice come un indirizzo, non come una password.
Gli short code dovrebbero essere sequenziali o casuali?
Usa codici casuali per i link pubblici e ID sequenziali solo internamente. I codici sequenziali sono brevi e senza collisioni, ma rivelano quanti link esistono e permettono ai concorrenti di raccoglierli. Un codice casuale ti costa un retry sul vincolo di unicità in rari casi ed elimina il problema dell'enumerazione.
Prova Elido
Incolla un URL, ottieni un link breve
Senza registrazione. Il link vive 30 giorni. Iscriviti per conservarlo.
Gratis, nessuna registrazione richiesta · 2 al giorno