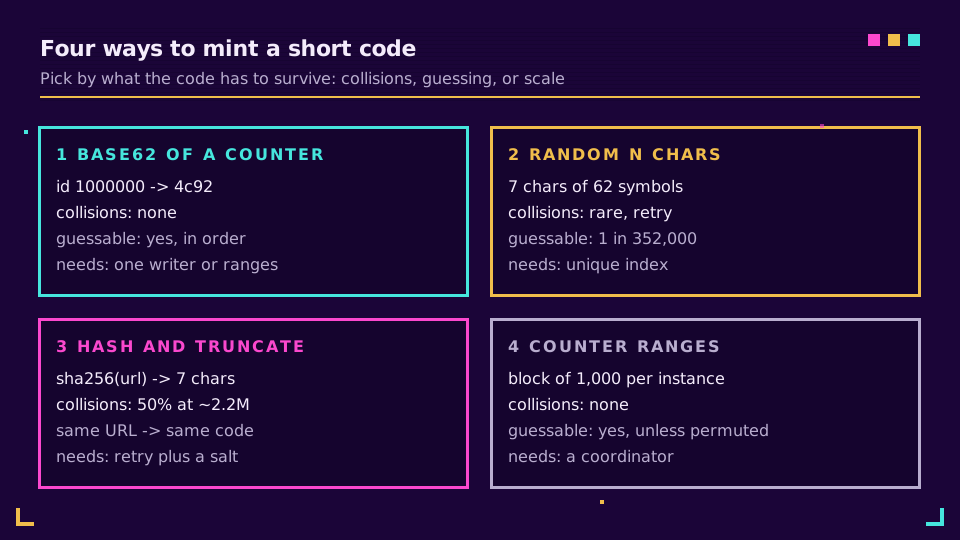
La génération de codes courts se résume à quatre options : encoder un compteur unique en base62, tirer des caractères au hasard, tronquer un hachage de l'URL, ou distribuer des plages d'identifiants depuis un coordinateur. Les compteurs n'entrent jamais en collision mais sont devinables. Les codes aléatoires ne sont pas devinables mais nécessitent un chemin de nouvelle tentative. Hacher puis tronquer est la plus faible des quatre, car cela entre en collision plus tôt que les gens ne le pensent et ne vous apporte rien que les autres n'apportent pas.
Les chiffres décident de l'essentiel ; cet article les passe donc en revue. Un code base62 de 7 caractères a exactement 3 521 614 606 208 valeurs, et un code aléatoire a 50 % de chances d'au moins une collision après environ 2,2 millions de liens. Le premier fait donne l'impression que 7 caractères, c'est énorme. Le second est la borne des anniversaires, et c'est pourquoi "des billions de possibilités" ne signifie pas "aucune collision".
Si vous voulez tout le système autour du code (stockage, redirections, mise en cache), commencez par comment construire un raccourcisseur d'URL. Ceci est le gros plan sur une décision de cette présentation : d'où vient le code court.
Encodage base62 d'un identifiant auto-incrémenté
L'encodage base62 convertit un nombre en une chaîne sur les 62 symboles 0-9, a-z, A-Z. C'est la même idée que l'hexadécimal avec un alphabet plus grand, et c'est la forme textuelle sûre pour les URL la plus courte d'un entier qui évite la ponctuation. L'identifiant 125 devient 21 (2 x 62 + 1), et 1,000,000 devient 4c92.
const ALPHABET =
  "0123456789abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ";

export function encode(id: bigint): string {
  if (id === 0n) return ALPHABET[0];
  let out = "";
  while (id > 0n) {
    out = ALPHABET[Number(id % 62n)] + out;
    id /= 62n;
  }
  return out;
}

export function decode(code: string): bigint {
  let id = 0n;
  for (const ch of code) id = id * 62n + BigInt(ALPHABET.indexOf(ch));
  return id;
}
La force est que l'unicité est héritée de la base de données. La ligne 41 000 000 reçoit un code et personne d'autre ne l'obtiendra jamais. Il n'y a ni boucle de nouvelle tentative ni recherche avant l'insertion. Les codes grandissent aussi lentement : les identifiants inférieurs à 62^6 donnent des codes de six caractères ou moins, et le premier code de 7 caractères apparaît à l'identifiant 56 800 235 584.
La faiblesse est l'exposition. Le code est le numéro de ligne déguisé, de sorte que decode("4c92") renvoie 1000000. N'importe qui peut compter vos liens, estimer votre croissance à partir de deux échantillons espacés d'une semaine, et parcourir chaque code dans l'ordre. Pour un outil interne, c'est acceptable. Pour un raccourcisseur public, c'est une API d'aspiration gratuite, ce qui compte pour les risques de redirection ouverte et d'énumération traités ailleurs sur ce blog.
Vous pouvez masquer l'ordre sans perdre l'unicité en faisant passer l'identifiant dans une permutation inversible (un petit réseau de Feistel est le choix habituel) avant l'encodage. Méfiez-vous des raccourcis. Multiplier par une constante modulo 62^7 semble brouillé mais laisse le dernier chiffre s'incrémenter, ce qu'un test rapide montre. Un compteur brouillé est de l'obscurcissement, pas du secret.
Codes aléatoires : espace de clés, nouvelles tentatives et borne des anniversaires
Un code court aléatoire tire chaque caractère indépendamment dans l'alphabet. Utilisez une source cryptographique et un tirage non biaisé. randomInt(62) dans Node fait l'échantillonnage par rejet pour vous, alors que byte % 62 fausse la distribution parce que 256 n'est pas un multiple de 62.
import { randomInt } from "node:crypto";

export function randomCode(length = 7): string {
  let out = "";
  for (let i = 0; i < length; i++) out += ALPHABET[randomInt(62)];
  return out;
}
Quelle longueur doit avoir le code ? L'espace de clés est 62^longueur, et le problème des anniversaires dit que parmi n tirages aléatoires dans N valeurs, la probabilité d'au moins une répétition est d'environ 1 - e^(-n²/2N). Elle atteint 50 % à environ sqrt(2N ln 2) tirages. Le problème des anniversaires est contre-intuitif parce que les paires croissent avec le carré de n.
| Longueur | Espace de clés (62^L) | Codes aléatoires jusqu'à 50 % de chances de répétition | Probabilité qu'une nouvelle insertion entre en collision à 100 M de liens |
|---|---|---|---|
| 6 | 56,800,235,584 | environ 280,600 | 1 sur 568 (0.18%) |
| 7 | 3,521,614,606,208 | environ 2,209,500 | 1 sur 35,216 (0.0028%) |
| 8 | 218,340,105,584,896 | environ 17,397,800 | 1 sur 2,183,401 (0.000046%) |
La dernière colonne est le chiffre qui compte sur le plan opérationnel. Une répétition parmi tous vos liens est quasi certaine à grande échelle, mais ce que votre code vit réellement, c'est une insertion unique qui tombe sur un emplacement occupé, et cette probabilité vaut simplement liens / espace de clés. Avec 100 millions de liens et 7 caractères, une insertion sur environ 35 000 entre en collision. Vous le verrez en production ; il vous faut donc un chemin de nouvelle tentative, mais il est peu coûteux.
Gestion des collisions : laissez la base de données trancher
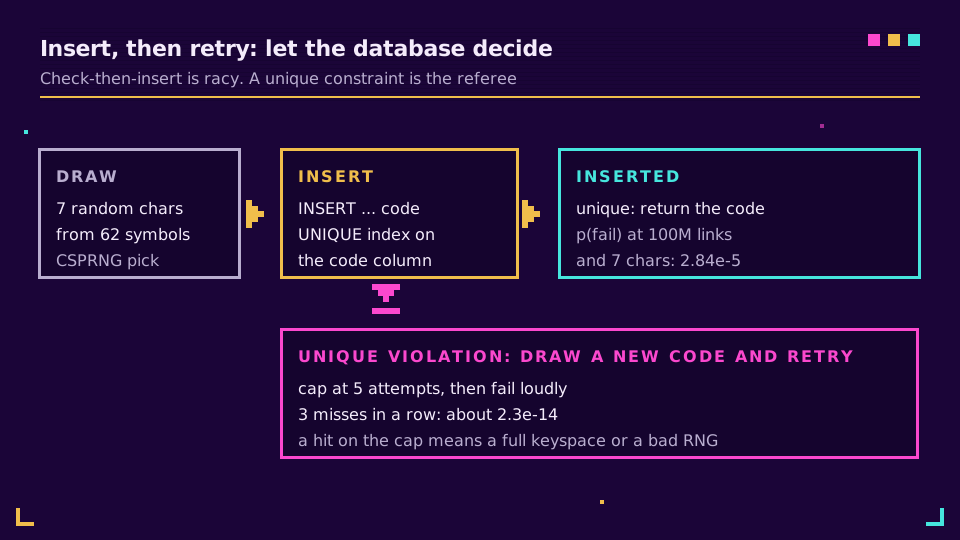
Le schéma qui fonctionne est insérer puis réessayer (insert-then-retry), pas vérifier puis insérer. Deux requêtes peuvent toutes deux vérifier que aB3x9Qz est libre, puis l'écrire toutes les deux. Une contrainte d'unicité sur la colonne du code ferme cette condition de concurrence, et l'insertion échouée est votre signal pour tirer à nouveau.
export async function createWithRetry(
  tryInsert: (code: string) => Promise<boolean>, // false = unique violation
  attempts = 5,
): Promise<string> {
  for (let i = 0; i < attempts; i++) {
    const code = randomCode();
    if (await tryInsert(code)) return code;
  }
  throw new Error("could not allocate a short code");
}
Ici tryInsert exécute votre INSERT et renvoie false uniquement sur une erreur de violation d'unicité, jamais sur d'autres échecs. Si une insertion unique entre en collision avec une probabilité p, toutes les tentatives échouent avec une probabilité p^tentatives. Au point de 100 M de liens et 7 caractères, p vaut 2.84 x 10^-5, de sorte que trois échecs d'affilée représentent environ 2.3 x 10^-14. Plafonnez tout de même les tentatives. Si vous voyez un jour le plafond atteint, l'espace de clés est presque plein ou la source aléatoire est défaillante, et une erreur bruyante vaut mieux qu'une boucle infinie.
La même discipline s'applique à l'idempotence sur le point de terminaison de création, car une requête HTTP rejouée (retry) ne doit pas produire un second lien. Limites de débit et idempotence traite cette moitié.
Hacher et tronquer : pourquoi cela entre en collision plus tôt que vous ne le pensez
Hacher l'URL paraît séduisant parce que c'est déterministe : la même URL donne toujours le même code, ce qui permet de sauter une recherche de doublons. Le coût est qu'un code n'a qu'un nombre limité de bits à dépenser. Prendre 32 bits d'une empreinte donne 2^32 = 4 294 967 296 valeurs, et le point de collision à 50 % est d'environ 77 163 URL. Pas des milliards. Une tranche base62 de 7 caractères (environ 41,7 bits) le porte à environ 2,2 millions, soit autant qu'un code aléatoire de 7 caractères.
import { createHash } from "node:crypto";

export function hashCode(url: string, length = 7): string {
  const digest = createHash("sha256").update(url).digest();
  const n = digest.readBigUInt64BE(0) % 62n ** BigInt(length);
  return encode(n).padStart(length, "0");
}
La troncature ne casse donc pas le hachage. SHA-256 est très bien. La résistance aux collisions des 256 bits complets ne survit tout simplement pas à une coupe à 41 bits. Vous héritez du comportement d'un code aléatoire ; vous avez donc toujours besoin du chemin de nouvelle tentative, plus une règle pour le cas d'un conflit (saler et re-hacher). Et le déterminisme joue contre vous : deux clients qui raccourcissent la même URL obtiennent le même code et donc le même flux de clics, à moins que vous n'y mêliez un identifiant de compte. Je laisserais de côté hacher-et-tronquer dans presque tous les cas. Si vous voulez dédupliquer, recherchez l'URL par une colonne de hachage et générez tout de même le code d'une autre manière.
Plages de compteurs et identifiants de type Snowflake
Une seule colonne auto-incrémentée devient un goulot d'étranglement quand plusieurs écrivains dans plusieurs régions ont besoin d'identifiants. Deux schémas l'évitent sans renoncer à l'unicité.
Le premier est celui des plages de compteurs. Un coordinateur remet à chaque instance d'application un bloc, disons 1 000 identifiants, et l'instance les encode localement sans aller-retour par lien. Si une instance meurt, son bloc inutilisé est simplement sauté. Des trous dans un espace de codes de billions sont sans conséquence.
Le second est un identifiant de type Snowflake : un horodatage, un identifiant de machine et une séquence par milliseconde regroupés sur 64 bits. Ils se trient par date de création et n'ont besoin d'aucun coordinateur. Le piège pour les liens courts est la longueur. Une valeur de 64 bits va jusqu'à 18 446 744 073 709 551 615, et comme 62^10 = 839 299 365 868 340 224 est inférieur à 2^64, elle demande jusqu'à 11 caractères base62. Ce n'est pas très court. Les identifiants Snowflake conviennent mieux aux clés de base de données qu'aux codes publics ; la plupart des raccourcisseurs les gardent donc en interne et utilisent un code distinct, plus court.
Les deux héritent du problème de devinabilité séquentielle, car les deux sont ordonnés par construction. Enveloppez-les dans une permutation, ou n'utilisez l'un d'eux que comme clé primaire interne.
Codes personnalisés et mots réservés
Les slugs personnalisés sont le seul endroit où un humain choisit le code, et ils passent par la même contrainte d'unicité que tout le reste. Le travail supplémentaire est la validation avant l'insertion. Une fin de lien personnalisée comme /spring-sale doit être vérifiée selon trois critères.
- Les mots réservés. Les chemins que votre application ou le web utilisent déjà ne doivent jamais pouvoir être revendiqués :
api,admin,login,static,robots.txt,favicon.icoet.well-known. Un raccourcisseur qui laisse quelqu'un enregistrer/logina construit un générateur de pages d'hameçonnage. - Les collisions avec les codes générés. Si un utilisateur prend
/aB3x9Qz, votre générateur aléatoire peut plus tard produire la même chaîne. La contrainte d'unicité s'en charge, tant que les codes personnalisés et générés partagent un seul espace de noms. - La casse et les caractères ressemblants. Le base62 est sensible à la casse, donc
/Abet/absont des liens différents. Décidez si les slugs personnalisés sont comparés sans tenir compte de la casse, et envisagez de bloquer les paires qui ne diffèrent que par0/Ooul/1. Le guide des URL personnalisées couvre le côté marque.
Des codes aléatoires de 7 caractères peuvent aussi épeler quelque chose de malheureux. Passez les codes générés dans une courte liste de blocage et retirez au hasard en cas de correspondance. Cela ne coûte presque rien.
Énumération, devinabilité et vie privée
Un code court est une adresse. Ce n'est pas un secret, et aucune longueur n'en fait un. Pourtant, la différence entre séquentiel et aléatoire est grande. Avec des codes séquentiels, chaque tentative tombe sur un lien actif. Avec 10 millions de liens répartis aléatoirement sur 62^7 valeurs, une tentative à l'aveugle en touche un avec une probabilité de 10 000 000 / 3 521 614 606 208, soit environ 1 sur 352 000. Un scanner a besoin de centaines de milliers de requêtes par trouvaille, ce que la limitation de débit et la détection de robots peuvent sanctionner.
Si une destination doit rester privée, le code doit être une capacité. Cela signifie au moins 128 bits d'aléa, soit en base62 22 caractères (62^22 vaut environ 2^131 ; 21 caractères ne donnent qu'environ 2^125). Il faut aussi un vrai contrôle d'accès derrière. Les recommandations de l'OWASP sur les références directes non sécurisées à des objets font la même remarque : des identifiants imprévisibles aident, mais l'autorisation est le contrôle. Les liens protégés par mot de passe ou à durée limitée sont pour les cas où un code divulgué ferait mal. La liste de contrôle de sécurité des raccourcisseurs d'URL énumère les contrôles à y associer, et la mécanique du fonctionnement des raccourcisseurs explique pourquoi le code seul ne peut jamais porter la confiance.
La source d'aléa compte pour la même raison. Un générateur non cryptographique initialisé par une graine peut être prédit à partir de quelques sorties ; utilisez donc le CSPRNG de la plateforme, comme dans l'extrait ci-dessus. Pour des alternatives prêtes à l'emploi, nanoid implémente l'approche du tirage non biaisé avec un alphabet et une longueur configurables.
Quelle approche choisir
Choisissez selon ce que le code doit supporter.
- Outil interne, faible volume : base62 d'un identifiant auto-incrémenté. Simple, sans collision, et la devinabilité n'a pas d'importance.
- Raccourcisseur public, une seule base de données : codes aléatoires de 7 caractères avec insertion et nouvelle tentative. Je commencerais ici. Le tableau ci-dessus montre que les probabilités de collision restent minuscules pendant des années, et passer plus tard à 8 caractères est un changement d'une ligne qui garde valides tous les liens existants.
- Écritures multi-régions : plages de compteurs ou identifiants Snowflake comme clé interne, plus une permutation ou un code aléatoire pour ce que voit le public.
- Hacher-et-tronquer : seulement si vous avez besoin de codes déterministes, et traitez-le alors comme un code aléatoire avec une moins bonne gestion des nouvelles tentatives.
Quoi que vous choisissiez, stockez le code dans une colonne à index unique et gardez la génération hors du chemin de redirection, où un cache à deux niveaux fait le vrai travail (l'article sur la latence p95 montre à quoi ressemble ce chemin une fois optimisé). Si vous préférez ne pas gérer vous-même la génération de codes, le traitement des collisions et les listes de mots réservés, l'API d'Elido prend une destination et renvoie un lien court, avec des fins de lien personnalisées validées pour vous. Consultez les offres quand vous voudrez l'essayer.
Sur le même sujet dans le blog
- Comment construire un raccourcisseur d'URL - l'architecture complète sur laquelle cet article fait un gros plan.
- Comment fonctionnent les raccourcisseurs d'URL - l'introduction conceptuelle.
- Qu'est-ce qu'une fin de lien personnalisée ? - la moitié de l'espace de codes choisie par un humain.
- Stratégie de cache pour les redirections d'URL - ce qui se passe une fois le code créé.
- Vulnérabilités de redirection ouverte - pourquoi le code doit correspondre à une destination stockée.
- Liste de contrôle de sécurité des raccourcisseurs d'URL
Questions fréquentes
Qu'est-ce que l'encodage base62 dans un raccourcisseur d'URL ?
L'encodage base62 écrit un nombre avec 62 symboles : 0-9, a-z et A-Z. Un raccourcisseur d'URL prend un entier unique, généralement un identifiant de base de données, et le convertit en une chaîne compacte comme 1Ly7. Comme chaque entier est unique, chaque code base62 est unique, de sorte qu'il n'y a aucune collision à gérer.
Combien d'URL un code court de 7 caractères peut-il contenir ?
Un code base62 de 7 caractères a 62^7 = 3 521 614 606 208 valeurs possibles, soit environ 3,5 billions. À 1 000 nouveaux liens par seconde, il faut environ 111 ans pour l'épuiser si vous attribuez les codes séquentiellement. Les codes aléatoires connaissent leurs premières collisions bien plus tôt, vers 2,2 millions de liens pour 50 % de chances d'en avoir au moins une.
Hacher une URL est-il un bon moyen de générer un code court ?
Généralement non. Tronquer un hachage tel que SHA-256 en un code court jette la plus grande partie de l'empreinte, de sorte que des URL différentes finissent par entrer en collision, et vous avez toujours besoin d'une logique de nouvelle tentative. Des URL identiques correspondent aussi au même code, ce qui vous empêche de donner à deux utilisateurs des liens distincts avec des analyses distinctes.
Comment éviter les collisions lors de la génération d'URL courtes ?
Soit rendre les collisions impossibles, soit les rendre récupérables. Encoder un compteur unique en base62 ne peut pas entrer en collision. Pour les codes aléatoires ou hachés, insérez avec une contrainte d'unicité sur la colonne du code et réessayez avec un nouveau code quand l'insertion échoue. Vérifier puis insérer est sujet aux conditions de concurrence ; laissez la base de données trancher.
Quelqu'un peut-il deviner ou énumérer des liens courts ?
Oui, si les codes sont séquentiels. N'importe qui peut parcourir /1, /2, /3 et lire chaque destination. Des codes aléatoires de 7 caractères font qu'une tentative à l'aveugle tombe sur un lien actif environ une fois sur 350 000 avec 10 millions de liens, ce qui ralentit les scanners sans rendre un lien privé. Traitez le code comme une adresse, pas comme un mot de passe.
Les codes courts doivent-ils être séquentiels ou aléatoires ?
Utilisez des codes aléatoires pour les liens publics et des identifiants séquentiels uniquement en interne. Les codes séquentiels sont courts et sans collision, mais révèlent combien de liens existent et permettent aux concurrents de les aspirer. Un code aléatoire vous coûte une nouvelle tentative sur contrainte d'unicité dans de rares cas et supprime le problème d'énumération.
Essayer Elido
Collez une URL, obtenez un lien court
Sans inscription. Lien actif 30 jours. Inscrivez-vous pour le garder pour toujours.
Gratuit, sans inscription · 2 par jour