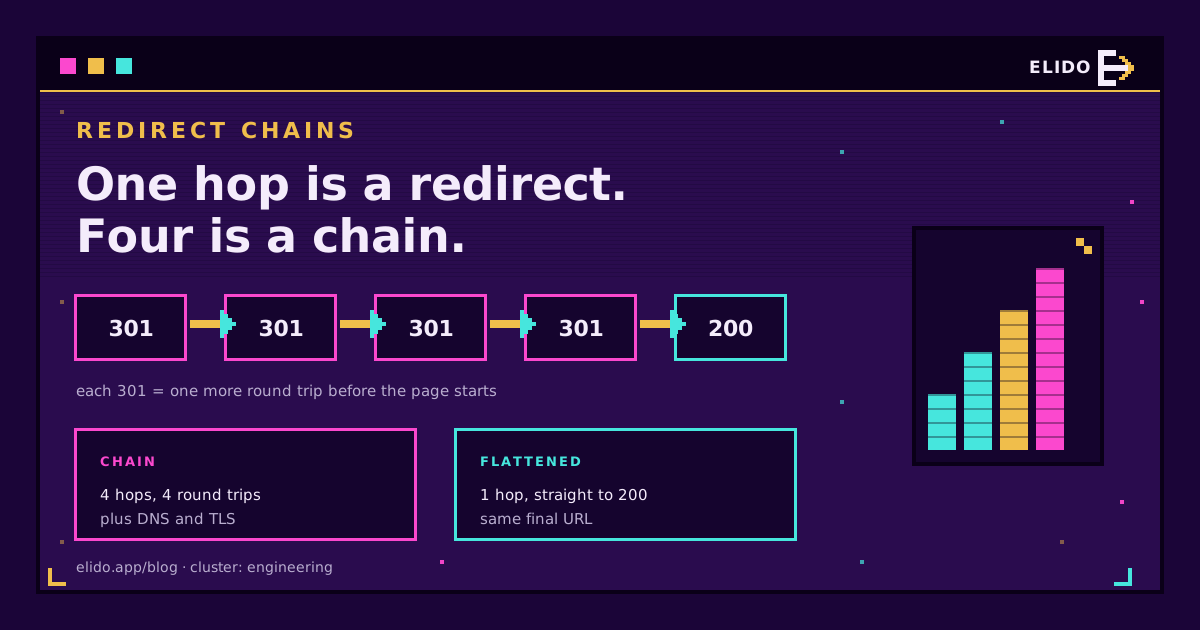
Une chaîne de redirections est un enchaînement de deux redirections ou plus entre l'URL demandée par quelqu'un et la page qui répond enfin par un 200. Google documente que Googlebot suit jusqu'à 10 sauts, recommande de rediriger directement vers la destination finale, et cite les longues chaînes comme un frein au crawl. Il ne dit pas qu'elles détruisent le classement, et il dit que les redirections permanentes ne causent pas de perte de PageRank. Le résumé honnête est donc que les chaînes sont un problème de latence et d'efficacité du crawl que vous devriez corriger à peu de frais, pas une catastrophe SEO.
La plupart des chaînes ne sont pas construites exprès. Quelqu'un ajoute une règle HTTPS, quelqu'un d'autre une règle www, un outil marketing enveloppe le lien dans un traceur, et chaque saut est raisonnable pris isolément. Ci-dessous : comment les couches s'empilent, ce que coûte chaque saut, quelles affirmations SEO tiennent face à la documentation de Google, et comment tracer et aplatir une chaîne. Pour le vocabulaire des codes de statut d'abord, les types de redirections d'URL en est la carte. Si la chaîne boucle sur elle-même, c'est plutôt comment corriger une boucle de redirection qu'il vous faut.
Ce qu'est une chaîne de redirections
Une chaîne de redirections se produit quand l'URL A redirige vers B, et B redirige vers C, au lieu que A pointe directement vers C. Chaque flèche est sa propre réponse HTTP, et le client fait une nouvelle requête pour chacune. Une redirection est normale ; la "chaîne" commence à deux.
Redirections multiples et sauts de redirection décrivent la même chose sous des angles différents : le nombre de redirections entre la requête et la page finale. Une boucle de redirection est une chaîne qui ne finit jamais parce qu'elle revisite une URL. Une chaîne, au contraire, finit ; elle met simplement trop de temps à y arriver.
Comment se forment les chaînes de redirections
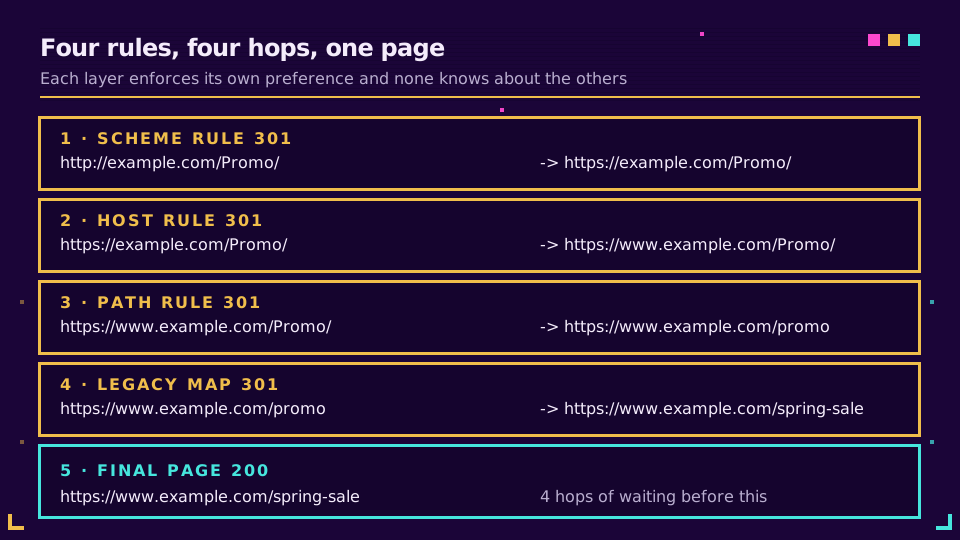
Les chaînes s'empilent parce que chaque couche impose sa propre préférence. Les couches habituelles, dans l'ordre où une requête les rencontre :
- Schéma.
http://va vershttps://, généralement dans une règle de serveur ou de proxy. - Hôte. L'apex va vers
www, ou l'inverse, dans une autre règle qui se déclenche après la règle de schéma. - Chemin. Un normaliseur de barre oblique finale ou de casse réécrit
/Promo/en/promo. - Enveloppe de campagne ou de suivi. Un traceur de clics publicitaires, le réécrivain de liens d'une plateforme d'e-mail ou un lien court se place devant tout le reste.
- Table héritée. Une redirection d'une ancienne refonte que personne n'a repointée.
Mettez-les ensemble et un simple http://example.com/Promo/ peut prendre quatre sauts : vers HTTPS, puis vers www, puis vers le chemin normalisé, puis par une ancienne règle de refonte vers la page active. Les liens courts se joignent au début. L'un d'eux est un saut légitime. Le mal commence quand sa destination n'est pas l'URL finale. Collez http://example.com/promo comme cible et votre lien ouvre une chaîne que le site de destination a construite, à votre insu. Les raccourcisseurs d'URL nuisent-ils au SEO couvre le côté classement de cette question ; la réponse courte est qu'un saut propre est acceptable et qu'un saut empilé est à vous de le corriger.
Les chaînes passent facilement inaperçues parce que les navigateurs les cachent : la barre d'adresse montre l'URL finale et la page se charge, donc rien ne semble anormal. Elles n'apparaissent aussi que pour la variante de requête qui déclenche toutes les règles, généralement le plus ancien lien http:// sur le plus ancien support imprimé.
Combien de sauts Googlebot suit-il ?
Googlebot suit jusqu'à 10 sauts de redirection par défaut. Cela vient directement de la documentation du robot d'exploration de Google. Elle ajoute que certains produits Google peuvent utiliser des limites différentes, et que l'outil d'inspection d'URL ne suit pas du tout les redirections. Google ne précise pas ce qui arrive à une chaîne plus longue ; supposez donc que la cible n'est simplement pas atteinte.
Dix est un plafond, pas une recommandation. Les recommandations de Google pour un déménagement de site disent de rediriger directement vers la destination finale et, quand ce n'est pas possible, de garder la chaîne courte, "idéalement pas plus de 3 et moins de 5", parce que l'enchaînement ajoute de la latence pour les utilisateurs et que tous les agents utilisateurs ne prennent pas en charge les longues chaînes. Retenez ceci : un objectif d'un saut, une tolérance de quelques-uns, et un arrêt net à dix.
Les navigateurs ont leurs propres limites. Chrome abandonne à 20 et renvoie ERR_TOO_MANY_REDIRECTS, le symptôme traité dans le guide des boucles de redirection. Le standard HTTP ne fixe pas non plus de nombre : la RFC 9110 dit seulement que les clients devraient détecter les redirections cycliques et intervenir.
Ce que coûte chaque saut en latence
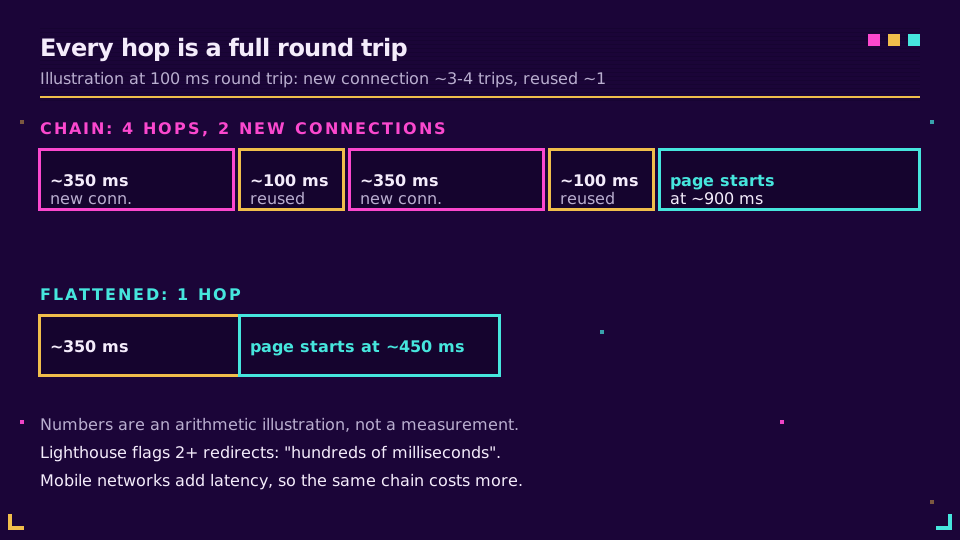
Chaque saut coûte au moins un aller-retour réseau. Un saut vers un nom d'hôte différent coûte plus. Le client résout le nouveau nom, ouvre une connexion TCP et termine une négociation TLS avant de pouvoir envoyer quoi que ce soit. L'audit propre de Lighthouse fait échouer une page avec deux redirections ou plus et dit que l'aller-retour supplémentaire peut retarder une ressource "de centaines de millisecondes".
Voici l'arithmétique, à titre d'illustration et non de benchmark. Supposez un aller-retour de 100 ms, ce qui est ordinaire pour une connexion mobile avec un signal moyen. Un saut vers un nouvel hôte avec DNS, TCP et une négociation TLS 1.3 avant la requête peut facilement coûter trois à quatre allers-retours, soit 300 à 400 ms. Un saut qui réutilise une connexion ouverte vers le même hôte en coûte un, soit 100 ms. Une chaîne de quatre sauts avec deux nouvelles connexions dépense alors environ 900 ms avant que la vraie page ne démarre, contre environ 450 ms pour une seule redirection à plat.
Le mobile aggrave les choses pour une raison simple : la contrainte est la latence, pas la bande passante. Les réponses de redirection sont minuscules, donc l'attente n'est faite que d'allers-retours, et une offre plus rapide n'y change rien. Supprimer un saut est souvent moins coûteux que réduire une image. Pour ce qu'un saut unique devrait coûter côté serveur, voyez comment les redirections passent sous 15 ms.
Les chaînes perdent aussi des données. Chaque saut est un endroit où une règle de réécriture peut supprimer une chaîne de requête, et un utm_source supprimé est la façon habituelle dont les paramètres UTM disparaissent des analyses.
Link equity et budget de crawl : ce que Google documente
D'abord le link equity. La documentation de Google sur le déménagement de site indique que "les redirections 301 et les autres redirections permanentes ne causent pas de perte de PageRank". Gary Illyes de Google a dit la même chose des redirections 30x en 2016, mais c'était une publication sur un réseau social, pas de la documentation. La vieille règle empirique selon laquelle chaque saut de redirection fait fuir un pourcentage fixe d'equity est donc du folklore. Aucune source de Google ne donne de pourcentage, et vous verrez des chiffres comme 15 pour cent répétés dans des articles SEO sans citation. Si quelqu'un vous en donne un, demandez la source.
Les chaînes ne sont pas gratuites pour autant. Deux effets sont documentés. Premièrement, l'efficacité du crawl : les recommandations de Google sur le budget de crawl pour les grands sites disent clairement d'éviter les longues chaînes de redirections, qui ont un effet négatif sur l'exploration. Deuxièmement, la latence pour l'utilisateur, traitée plus haut, qui alimente les signaux d'expérience de page. Le budget de crawl compte surtout sur les très grands sites ou ceux qui changent vite ; un site de 200 pages risque peu de subir un problème de budget de crawl à cause de quelques chaînes, bien que les visiteurs en ressentent toujours le coût en vitesse.
Il y a aussi une nuance d'indexation. Google utilise les redirections permanentes comme signal canonique pour la cible. L'URL affichée dépend en partie du caractère temporaire ou permanent de chaque redirection. Une chaîne qui mélange des sauts 301 et 302 rend ce signal moins clair, ce qui est une bonne raison de fixer les codes une fois pour toutes. Canonical vs redirection 301 détaille comment ces signaux interagissent.
Ma position : ne paniquez pas pour l'equity, corrigez les chaînes pour la vitesse et l'hygiène du crawl, et ne promettez pas un gain de classement en en aplatissant une. Personne n'a documenté ce gain. Des chargements plus rapides et moins de requêtes inutiles sont ce que vous pouvez mesurer.
Comment détecter les chaînes de redirections
Commencez par curl, car il affiche chaque saut là où un navigateur les cache. La première commande montre la ligne de statut et le Location de chaque réponse :
curl -sIL http://example.com/Promo/ | grep -E '^HTTP|^[Ll]ocation'
Un résultat propre est un 3xx puis un 200. Une chaîne montre d'abord deux lignes 3xx ou plus. Pour un décompte et le temps passé dans les redirections, demandez à curl ses propres chiffres :
curl -sL -o /dev/null \
  -w 'hops: %{num_redirects}\nfinal: %{url_effective}\nredirect time: %{time_redirect}s\ntotal: %{time_total}s\n' \
  http://example.com/Promo/
Deux réserves. -I envoie une requête HEAD, et quelques serveurs répondent à HEAD différemment de GET ; si le résultat paraît trop propre, recommencez sans -I et écartez le corps avec -o /dev/null -D -. Et testez la variante du pire cas, celle qui déclencherait toutes les règles : http://, sans www, chemin en majuscules, barre oblique finale. Ne tester que l'URL canonique est la façon dont les chaînes survivent. Je préfère sur-tester les variantes moches que me fier à la propre.
Dans un navigateur, ouvrez les outils de développement, allez dans le panneau Network, cochez "Preserve log" pour que les sauts précédents survivent à la navigation, et rechargez. Chaque redirection apparaît comme une ligne 301 ou 302 distincte. Notre vérificateur de liens montre la même chaîne sans terminal.
Pour auditer tout un site, un robot de bureau comme Screaming Frog ou Sitebulb propose un rapport de chaînes de redirections qui liste chaque chaîne avec chaque saut et les codes de statut. Pour les liens de longue durée, placez le même traçage dans une tâche planifiée, comme dans la surveillance des redirections de liens.
Comment aplatir une chaîne de redirections
Aplatir signifie que chaque URL héritée pointe directement vers l'URL finale. Les étapes, dans l'ordre :
- Choisissez la forme canonique : schéma, hôte, politique de barre oblique finale et casse. Écrivez-la.
- Tracez chaque ancienne URL et notez sa destination finale.
- Réécrivez chaque règle pour cibler cette destination finale, pas la règle suivante.
- Mettez à jour les liens internes, les sitemaps et les balises
rel="canonical"vers l'URL finale, afin que les robots et les utilisateurs cessent d'entrer dans la chaîne. - Relancez le traçage et confirmez un saut au plus.
L'astuce côté serveur consiste à combiner schéma et hôte dans une seule règle. Dans nginx, cela donne ceci, en utilisant $request_uri pour que le chemin et la chaîne de requête survivent :
server {
    listen 80;
    server_name example.com www.example.com;
    return 301 https://www.example.com$request_uri;
}

server {
    listen 443 ssl;
    server_name example.com;
    # ssl_certificate and key directives go here
    return 301 https://www.example.com$request_uri;
}
Une requête http://example.com/page va maintenant vers https://www.example.com/page en un seul saut, là où deux règles en auraient produit deux. Configurer une redirection dans .htaccess et comment rediriger une URL couvrent les équivalents Apache et au niveau de l'application.
Testez d'abord avec 302. Les navigateurs mettent la 301 en cache de façon agressive, donc une erreur s'attarde. Une fois la chaîne réduite à un saut, passez au code permanent. HSTS aide aussi : après qu'un navigateur a vu un en-tête Strict-Transport-Security, il fait passer http:// en https:// en interne, de sorte que les visiteurs récurrents sautent complètement ce saut. Cela ne fait rien pour les robots ni pour les nouveaux visiteurs ; il complète donc la règle du saut unique sans la remplacer.
Si les chaînes ne cessent de réapparaître, la cause est le processus, pas la syntaxe ; la prévention de la pourriture des liens décrit l'habitude d'audit qui empêche les anciennes tables de s'accumuler.
À quoi ressemble la redirection d'un lien court bien conçu
Un lien court devrait être exactement un saut entre le slug et la page canonique finale, et rien d'autre. La requête atteint le domaine court. La réponse est un 3xx avec la destination dans Location. La destination répond 200 directement. Pas de raccourcisseur intermédiaire, pas de traceur qui redirige à nouveau, pas de destination qui saute vers www ou vers HTTPS parce que vous avez collé l'ancienne forme.
Le code dépend du cas d'usage.
302(ou307) pour les liens suivis et modifiables dans les campagnes, les publications sociales, les e-mails et les QR codes. Il vous permet de rediriger la destination plus tard et garde chaque clic passant par la couche de redirection pour que les analyses restent complètes.301(ou308) quand le déplacement est permanent et que vous voulez que la destination soit traitée comme canonique, comme une URL personnalisée qui remplace définitivement une ancienne adresse.
Redirections 301 vs 302 détaille le piège du cache qui rend la valeur par défaut 302 judicieuse. Deux habitudes gardent la chaîne à un saut. Collez toujours l'URL finale comme destination, après l'avoir chargée une fois et copié l'adresse depuis la barre, et lancez le décompte curl ci-dessus sur les nouveaux liens avant le lancement. Si vous voulez cette destination stockée une seule fois et modifiable sans réimprimer, commencez avec un espace de travail Elido gratuit et tracez votre premier lien avec les commandes de cet article.
Des tiers peuvent ajouter des sauts que vous ne contrôlez pas. Le traceur de clics d'une plateforme publicitaire ou l'enveloppe de liens d'un fournisseur d'e-mail se place devant votre lien court, que cela vous plaise ou non, ce qui est le meilleur argument pour garder votre propre part du chemin à un saut. Un domaine personnalisé n'en ajoute pas, comme l'explique les domaines personnalisés pour liens courts.
Cet article se place dans le cluster ingénierie. Pour la carte complète des codes de statut, lisez les types de redirections d'URL, et pour la couche de redirection derrière un lien court, comment fonctionnent les raccourcisseurs d'URL.
Sur le même sujet dans le blog
- Boucle de redirection : comment trouver et corriger ERR_TOO_MANY_REDIRECTS
- Types de redirections d'URL : 301, 302, 307, 308 et plus
- Redirections 301 vs 302 : laquelle les liens courts doivent-ils utiliser
- Les raccourcisseurs d'URL nuisent-ils au SEO ? La réponse honnête
- Canonical vs redirection 301 : comment choisir le bon signal
- Comment rediriger une URL : six façons, et quand chacune convient
Questions fréquentes
Combien de redirections sont de trop pour le SEO ?
Les recommandations de Google pour un déménagement de site disent de rediriger directement vers la destination finale et, si ce n'est pas possible, de limiter la chaîne idéalement à pas plus de 3 et à moins de 5 sauts. Googlebot lui-même suit jusqu'à 10 sauts ; c'est donc un plafond strict, pas une cible. En pratique, visez un seul saut et traitez tout ce qui dépasse deux comme un bogue à corriger.
Les chaînes de redirections perdent-elles du link equity ?
Google indique que les redirections 301 et les autres redirections permanentes ne causent pas de perte de PageRank ; une chaîne ne fait donc pas fuir de l'equity comme le prétendaient les anciens conseils SEO. Ce que les chaînes coûtent, c'est l'efficacité du crawl et la latence pour l'utilisateur, que Google documente tous deux. Traitez le chiffre ' chaque saut perd 15 pour cent ' comme du folklore : aucune source de Google ne donne ce nombre.
Combien de redirections Googlebot suivra-t-il ?
Jusqu'à 10 sauts par défaut, selon la documentation du robot d'exploration de Google. Certains produits Google peuvent utiliser des limites différentes, et l'outil d'inspection d'URL ne suit pas du tout les redirections. Les navigateurs s'arrêtent bien plus tôt sur les boucles : Chrome abandonne à 20 sauts avec ERR_TOO_MANY_REDIRECTS.
Une chaîne de redirections nuit-elle à la vitesse de la page ?
Oui, chaque saut ajoute un aller-retour réseau complet avant que la vraie page commence à se charger, et un saut vers un nouveau nom d'hôte peut y ajouter l'établissement DNS, TCP et TLS. Lighthouse signale une page avec deux redirections ou plus et décrit le retard comme potentiellement de centaines de millisecondes. Sur une connexion mobile lente, la pénalité est plus grande, pas plus petite.
Comment vérifier une chaîne de redirections ?
Exécutez curl -sIL https://example.com/page | grep -E '^HTTP|^[Ll]ocation' pour afficher dans l'ordre la ligne de statut et l'en-tête Location de chaque saut. Ajoutez -w '%{num_redirects}' pour compter les sauts, ou utilisez les outils de développement du navigateur avec l'option Preserve log du panneau Network activée. Un robot d'exploration comme Screaming Frog ou Sitebulb peut ensuite rapporter chaque chaîne sur tout un site.
Une 301 suivie d'une 302 pose-t-elle problème ?
C'est un saut supplémentaire avec des signaux contradictoires. Google traite les redirections permanentes comme un signal canonique pour la cible, tandis que les temporaires tendent à garder l'URL source dans les résultats ; une chaîne mixte rend donc le résultat moins prévisible. Fusionnez-la en une seule redirection dont le code correspond à l'intention réelle du déplacement.
Essayer Elido
Collez une URL, obtenez un lien court
Sans inscription. Lien actif 30 jours. Inscrivez-vous pour le garder pour toujours.
Gratuit, sans inscription · 2 par jour