
Importatorul Dub.co din Elido îți citește linkurile prin API-ul REST al Dub, câte 100 per cerere, și le creează pe un singur domeniu Elido cu același slug. Preia slug-ul, URL-ul de destinație, titlul și numele tagurilor. Nu preia dosarele, linkurile arhivate, istoricul de clicuri sau vreo setare a linkurilor. Acestea sunt faptele care contează dacă îți planifici o mutare.
O versiune anterioară a acestui articol susținea că dosarele Dub se aplatizează în taguri. Am recitit importatorul pentru această actualizare și era greșit: codul nu citește niciodată dosarele. Această versiune descrie ce face astăzi services/api-core/internal/imports/dub.go, verificat față de specificația API publicată de Dub (accesată 2026-10-02).
Ce cere importatorul de la Dub
Workerul trimite GET https://api.dub.co/links?page=N&pageSize=100 cu cheia ta ca token bearer. Potrivit documentației Dub despre cheile API (accesată 2026-10-02), o cheie este legată de un singur spațiu de lucru și poate fi creată doar pentru citire. O cheie doar pentru citire este tot ce are nevoie acest import, pentru că workerul doar listează linkuri și nu scrie niciodată în Dub.
Răspunsul este un simplu array JSON. Nu există un indicator „mai sunt", deci workerul continuă să ceară pagini până când una vine cu mai puțin de 100 de elemente sau goală:
if len(links) == 0 { break }
// ... import each link ...
if len(links) < dubPageSize { break } // last page
page++
O precizare din specificația Dub însăși: parametrul page este marcat ca depreciat în favoarea paginării cu cursor prin startingAfter. Încă funcționează astăzi, iar pageSize acceptă până la 100. Dacă Dub elimină page, importatorul va avea nevoie de o mică modificare, și mă aștept ca asta să apară ca un job eșuat cu o eroare HTTP clară, nu ca pierdere tăcută de date.
Pagina cu limitele de rată a Dub (accesată 2026-10-02) listează 60 de cereri pe minut pe planul Free și 600 pe Pro. Importatorul inserează linkurile unul câte unul în Postgres între cereri, deci în practică nu se apropie de limita Free. Nu are nici retry: un HTTP 429 sau orice răspuns diferit de 200 încheie jobul ca eșuat, cu codul de stare în mesaj.
Ce ajunge în Elido, câmp cu câmp
| Câmp Dub | În Elido | Note |
|---|---|---|
key | Slug | Supus strategiei de conflict de mai jos |
url | URL de destinație | Un link fără URL sau fără cheie este numărat ca eșuat |
title | Titlu | Trunchiat la 200 de caractere |
tags[].name | Taguri | Doar numele, culorile nu sunt preluate |
| (niciunul) | Tag imported:dub | Adăugat fiecărui link importat |
domain, folderId, archived, altele | Necitite | Vezi următoarele două secțiuni |
Tot restul de pe un link Dub este lăsat pe dinafară: descriere, imagine de previzualizare socială, expirare, parolă, țintire geografică și pe dispozitiv, câmpuri UTM, ținte iOS și Android, indicatori de urmărire a conversiilor. Dacă un link depinde de oricare dintre acestea, reconstruiește-l după import. Elido are propriile reguli de smart link pentru țintire, dar nimic nu mapează automat regulile Dub.

Dosare, linkuri arhivate și domenii
Trei concepte Dub nu sunt tratate, și fiecare te poate surprinde.
Dosare. În schema de linkuri Dub, un dosar apare doar ca un șir folderId. Importatorul nu are un câmp pentru el și nu face un al doilea apel pentru a rezolva numele dosarelor. Elido are taguri, nu dosare, deci chiar și un importator viitor ar trebui să le aplatizeze. Astăzi structura de dosare se pierde. Dacă contează, notează dosarul fiecărui slug înainte să începi, apoi etichetează lotul importat (filtrează după imported:dub) manual sau prin API.
Linkuri arhivate. Endpoint-ul de listare al Dub primește un parametru showArchived care implicit este false. Importatorul nu îl setează niciodată, deci linkurile arhivate nu sunt returnate și nu sunt importate. Este o valoare implicită rezonabilă pentru o migrare, dar ar trebui să o știi dacă păstrezi intenționat linkuri vechi de campanie arhivate.
Domenii ale linkurilor. Un spațiu de lucru Dub poate deține linkuri pe mai multe domenii. Importatorul le citește pe toate, ignoră câmpul domain și creează fiecare link pe singurul domeniu Elido pe care îl alegi. Dacă două domenii Dub folosesc aceeași cheie, al doilea intră în conflict. Strategia de conflict decide ce se întâmplă mai departe, deci alege-o ținând cont de asta.
Conflicte, limite și contractul workerului
Alegi o strategie de conflict când pornești jobul:
suffixîncearcămylink-2,mylink-3și tot așa până la-50, apoi renunță la acel link și îl numără ca eșuat.skiplasă în pace linkul Elido existent și înregistrează slug-ul ca omis.failoprește întregul job la primul conflict.
Per rulare, workerul se oprește la 50,000 de linkuri (MaxLinksPerImport) sau după 30 de minute (ImportRunBudget), oricare vine primul. Progresul este salvat la fiecare 50 de linkuri, iar panoul îl interoghează periodic. Jurnalul de erori păstrează cel mult 1,000 de intrări. Fiecare verificare de slug este o căutare indexată pe (domain_id, slug).
Nu am măsurat importurile Dub pe un cont mare, deci nu voi cita o cifră de linkuri pe minut. Bucla este o pagină HTTP de 100 de linkuri urmată de 100 de inserări secvențiale, deci durata depinde de cât de repede răspunde Dub și de baza ta de date. Testează mai întâi cu un spațiu de lucru mic.
Gestionarea tokenului și ce se întâmplă la un deploy
Cheia călătorește în corpul cererii POST /imports/dub, este ținută în memoria workerului care rulează și nu este stocată niciodată: câmpul source_token_id al rândului jobului rămâne gol. Doar textul opțional workspace_id ajunge în coloana source_filter a jobului.
Workerul rulează într-un goroutine detașat de cererea HTTP prin context.WithoutCancel. Asta îl ține în viață după răspuns și înseamnă totodată că un deploy sau o repornire îl oprește la mijlocul rulării. Un job de planificare rulează la fiecare 5 minute și marchează ca eșuat orice import running fără progres timp de 30 de minute. Rerularea este sigură sub suffix (primești copii -2 ale a tot ce a fost deja importat) și sub skip (slug-urile deja importate sunt omise). Nimic nu reia încă de la ultima pagină.
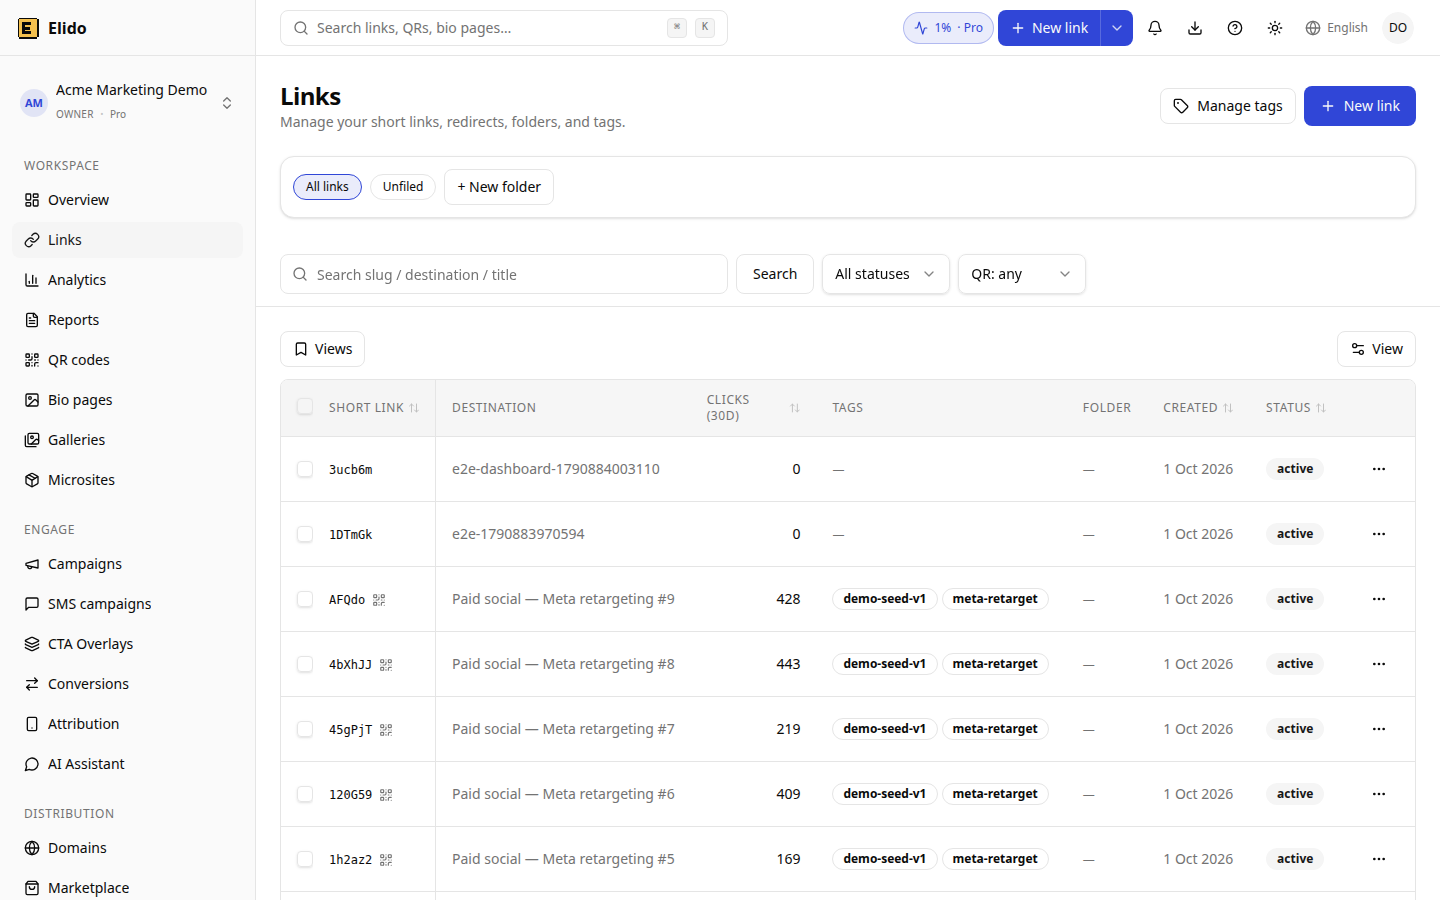
Lista de linkuri într-un spațiu de lucru demo cu date sintetice. După un import, filtrează după tagul imported:dub ca să găsești lotul.
O listă scurtă de verificare înainte să rulezi
- Creează o cheie API doar pentru citire în spațiul tău de lucru Dub.
- Dezarhivează orice linkuri arhivate pe care vrei să le păstrezi și notează orice structură de dosare pe care te bazezi.
- Adaugă domeniul țintă în Elido și alege
skipsausuffixștiind că toate domeniile Dub se contopesc în acesta. - Rulează importul din pagina de integrări din panou sau prin
POST /imports/dubcutoken,target_domain_idșiconflict_strategy. - Verifică prin sondaj slug-urile și destinațiile față de Dub, apoi actualizează DNS pentru orice domeniu personalizat pe care îl deții. Ghidul de comutare de la Bitly acoperă ordinea DNS, care este aceeași pentru orice furnizor.
Dacă încă te decizi dacă să muți deloc, Elido vs Dub compară planurile și funcțiile, iar GDPR pentru scurtatoarele de URL explică partea de rezidență a datelor. Ghidul orientat spre furnizor se află pe pagina de migrare Dub.
Mai multe pe blog
- Elido vs Dub: SSO, urmărirea conversiilor, rezidență UE
- Alternative la Dub: 6 platforme de management al linkurilor comparate
- Livrarea migrării Bitly: un worker, un token, un buget de 30 de minute
- Livrarea migrării Rebrandly: paginare de 25 pe pagină
- Livrarea migrării Short.io: paginare per domeniu la 150 pe pagină
Întrebări frecvente
Ce aduce importatorul Dub.co în Elido?
Pentru fiecare link pe care îl citește, importatorul preia slug-ul (cheia Dub), URL-ul de destinație, titlul (tăiat la 200 de caractere) și numele tagurilor, și adaugă un tag imported:dub. Nimic altceva nu este citit din înregistrarea Dub: nicio descriere, expirare, parolă, câmpuri UTM, reguli de țintire sau numărători de clicuri.
Supraviețuiesc dosarele mele Dub importului?
Nu. Endpoint-ul de listare al Dub returnează doar un folderId pentru fiecare link, nu numele dosarului, iar importatorul nu caută dosarele. Linkurile importate își păstrează tagurile, dar sosesc fără informații despre dosar. Dacă te bazezi pe dosare, notează ce tag sau tipar de slug corespunde fiecărui dosar înainte să începi.
Sunt importate linkurile Dub arhivate?
Nu implicit. Endpoint-ul de listare al Dub lasă deoparte linkurile arhivate dacă nu este trimis un parametru showArchived, iar importatorul nu îl trimite. Dezarhivează tot ce vrei să păstrezi sau recreează manual, înainte de a rula importul.
Pot filtra importul la un singur spațiu de lucru Dub?
O cheie API Dub aparține unui singur spațiu de lucru, deci cheia limitează deja ce este listat. API-ul acceptă un câmp opțional workspace_id și îl transmite către Dub ca parametru de interogare, dar parametrii de listare documentați de Dub nu îl includ. Formularul din panou nu are un asemenea câmp, deci consideră-l fără efect.
Câte linkuri poate importa o rulare și cât poate dura?
O rulare se oprește la 50,000 de linkuri sau 30 de minute, oricare vine primul, și citește 100 de linkuri per cerere. Peste această limită, jobul este marcat ca eșuat, cu un mesaj despre buget, în punctul în care s-a oprit. O rulare care nu face progres timp de 30 de minute este de asemenea măturată în starea eșuat.
Funcționează importatorul cu un Dub găzduit propriu?
Nu în prezent. Baza API este fixată la https://api.dub.co în cod și nu există nicio setare sau variabilă de mediu pentru a o schimba. O instanță Dub găzduită propriu nu poate fi vizată prin panou. Exportă-ți linkurile din propria bază de date și recreează-le prin API-ul Elido.
Încearcă Elido
Lipește un URL, obții un link scurt funcțional
Fără înregistrare. Linkul este activ timp de 30 de zile. Înregistrează-te ca să-l păstrezi pentru totdeauna.
Gratuit, fără înregistrare · 2 pe zi