
O importador do Dub.co do Elido lê os seus links pela API REST do Dub, 100 por requisição, e os cria em um domínio do Elido com o mesmo slug. Ele traz o slug, a URL de destino, o título e os nomes das tags. Não traz pastas, links arquivados, histórico de cliques nem nenhuma configuração dos links. Esses são os fatos que importam se você está planejando uma migração.
Uma versão anterior deste post afirmava que as pastas do Dub se achatam em tags. Reli o importador para esta atualização e isso estava errado: o código nunca lê pastas. Esta versão descreve o que services/api-core/internal/imports/dub.go faz hoje, conferido com a especificação de API publicada do Dub (acessada em 2026-10-02).
O que o importador pede ao Dub
O worker envia GET https://api.dub.co/links?page=N&pageSize=100 com a sua chave como bearer token. Segundo a documentação de chaves de API do Dub (acessada em 2026-10-02), uma chave é vinculada a um único workspace e pode ser criada como somente leitura. Uma chave somente leitura é tudo de que esta importação precisa, porque o worker apenas lista links e nunca escreve no Dub.
A resposta é um array JSON simples. Não há uma flag de "tem mais", então o worker continua pedindo páginas até que uma volte com menos de 100 itens, ou vazia:
if len(links) == 0 { break }
// ... import each link ...
if len(links) < dubPageSize { break } // last page
page++
Uma ressalva da própria especificação do Dub: o parâmetro page está marcado como obsoleto em favor da paginação por cursor com startingAfter. Ele ainda funciona hoje, e pageSize aceita até 100. Se o Dub remover page, o importador precisará de uma pequena mudança, e eu esperaria que isso aparecesse como um job falho com um erro HTTP claro, e não como perda silenciosa de dados.
A página de limites de taxa do Dub (acessada em 2026-10-02) lista 60 requisições por minuto no plano Free e 600 no Pro. O importador insere os links um a um no Postgres entre as requisições, então na prática não chega perto do limite do Free. Também não há nova tentativa: um HTTP 429 ou qualquer resposta diferente de 200 encerra o job como falho, com o código de status na mensagem.
O que chega ao Elido, campo a campo
| Campo do Dub | No Elido | Observações |
|---|---|---|
key | Slug | Sujeito à estratégia de conflito abaixo |
url | URL de destino | Um link sem URL ou sem key é contado como falho |
title | Título | Truncado em 200 caracteres |
tags[].name | Tags | Apenas os nomes, as cores não são trazidas |
| (nenhum) | Tag imported:dub | Adicionada a todo link importado |
domain, folderId, archived, outros | Não lidos | Veja as próximas duas seções |
Todo o resto em um link do Dub é descartado: descrição, imagem de pré-visualização social, expiração, senha, segmentação por região e dispositivo, campos UTM, destinos para iOS e Android, flags de rastreamento de conversão. Se um link depende de algum desses itens, reconstrua-o depois da importação. O Elido tem as suas próprias regras de smart links para segmentação, mas nada mapeia automaticamente as regras do Dub.

Pastas, links arquivados e domínios
Três conceitos do Dub não são tratados, e cada um pode surpreender.
Pastas. No esquema de links do Dub, uma pasta aparece apenas como uma string folderId. O importador não tem campo para isso e não faz uma segunda chamada para resolver os nomes das pastas. O Elido tem tags, não pastas, então até um importador futuro teria de achatá-las. Hoje a estrutura de pastas se perde. Se ela importa, anote a pasta de cada slug antes de começar e depois marque o lote importado (filtre por imported:dub) à mão ou pela API.
Links arquivados. O endpoint de listagem do Dub aceita um parâmetro showArchived cujo padrão é falso. O importador nunca o define, então os links arquivados não são devolvidos nem importados. É um padrão razoável para uma migração, mas você deve saber disso se mantém links de campanhas antigas arquivados de propósito.
Domínios dos links. Um workspace do Dub pode ter links em vários domínios. O importador lê todos, ignora o campo domain e cria todos os links no único domínio do Elido que você escolher. Se dois domínios do Dub usam a mesma key, o segundo gera um conflito. A estratégia de conflito decide o que acontece em seguida, então escolha-a pensando nisso.
Conflitos, limites e o contrato do worker
Você escolhe uma estratégia de conflito ao iniciar o job:
suffixtentamylink-2,mylink-3e assim por diante até-50, depois desiste desse link e o conta como falho.skipdeixa o link existente do Elido em paz e registra o slug como ignorado.failinterrompe o job inteiro no primeiro conflito.
Por execução, o worker para em 50.000 links (MaxLinksPerImport) ou após 30 minutos (ImportRunBudget), o que vier primeiro. O progresso é salvo a cada 50 links e o painel o consulta. O log de erros guarda no máximo 1.000 entradas. Cada verificação de slug é uma consulta indexada em (domain_id, slug).
Não fiz benchmark de importações do Dub com uma conta grande, então não vou citar um número de links por minuto. O laço é uma página HTTP de 100 links seguida de 100 inserções sequenciais, então a duração depende da rapidez com que o Dub responde e do seu banco de dados. Teste primeiro com um workspace pequeno.
Tratamento do token e o que acontece em um deploy
A chave viaja no corpo da requisição de POST /imports/dub, fica na memória do worker em execução e nunca é armazenada: o source_token_id da linha do job permanece vazio. Apenas o texto opcional workspace_id vai para a coluna source_filter do job.
O worker roda em uma goroutine desacoplada da requisição HTTP com context.WithoutCancel. Isso o mantém vivo depois da resposta, e também significa que um deploy ou reinício o mata no meio da execução. Um job do agendador roda a cada 5 minutos e marca como falha qualquer importação running sem progresso há 30 minutos. Executar de novo é seguro com suffix (você recebe cópias -2 de tudo que já foi importado) e com skip (os slugs já importados são ignorados). Nada retoma ainda a partir da última página.
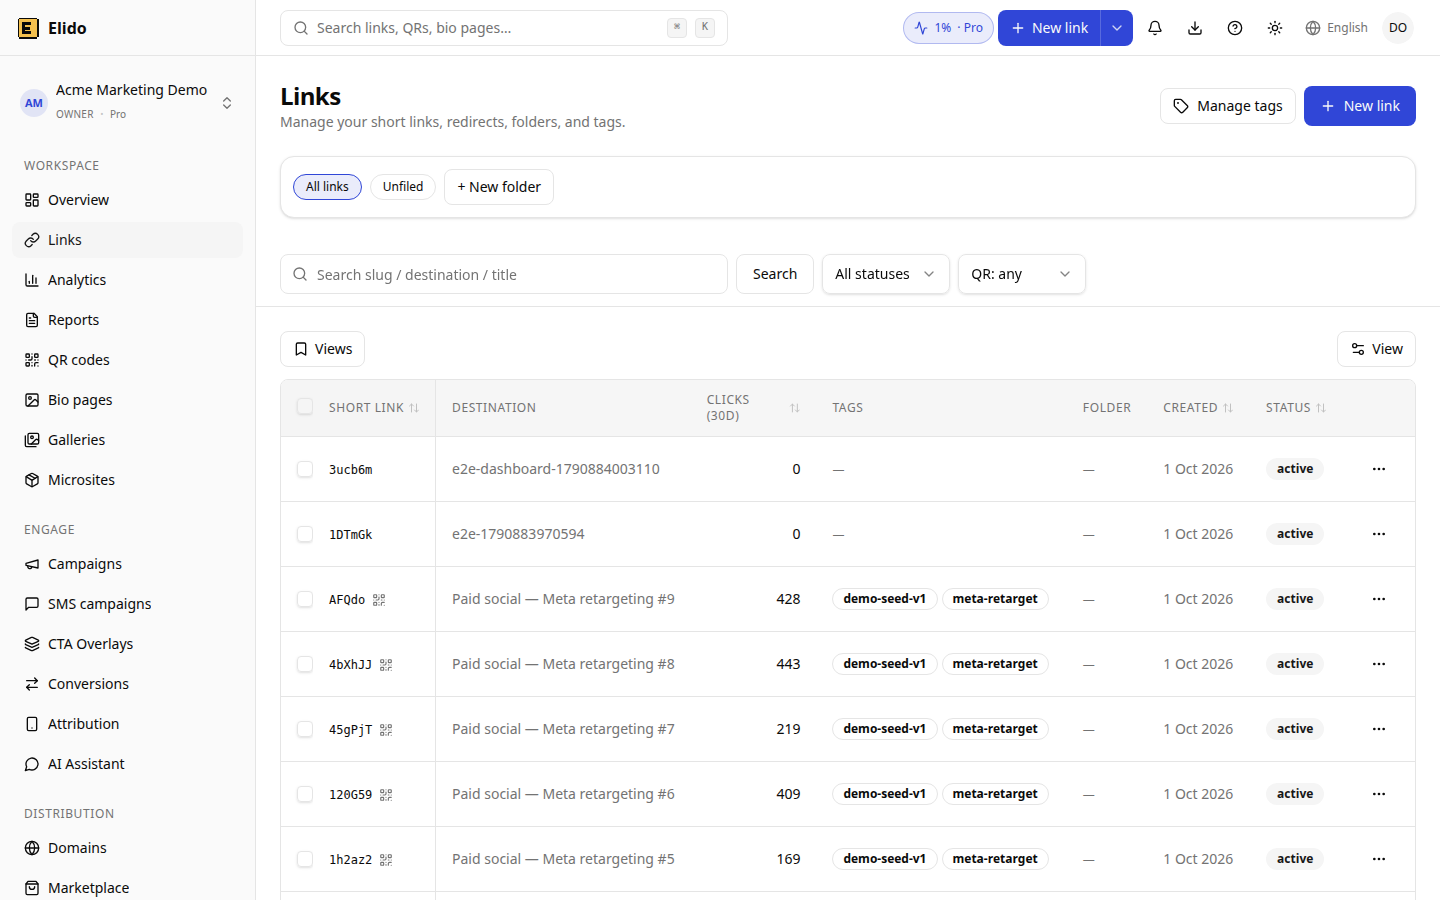
A lista de links em um workspace de demonstração com dados sintéticos. Depois de uma importação, filtre pela tag imported:dub para encontrar o lote.
Uma lista rápida antes de executar
- Crie uma chave de API somente leitura no seu workspace do Dub.
- Desarquive os links arquivados que quiser manter e anote qualquer estrutura de pastas da qual você dependa.
- Adicione o domínio de destino no Elido e escolha
skipousuffixsabendo que todos os domínios do Dub se reúnem nele. - Execute a importação pela página de integração do painel, ou com
POST /imports/dubpassandotoken,target_domain_ideconflict_strategy. - Confira por amostragem os slugs e destinos em relação ao Dub e depois atualize o DNS de qualquer domínio personalizado que você tenha. O playbook de transição do Bitly cobre a ordem do DNS, que é a mesma para qualquer fornecedor.
Se você ainda está decidindo se vale mudar, Elido vs Dub compara planos e recursos, e GDPR para encurtadores de URL explica o lado da residência de dados. O passo a passo voltado ao fornecedor está na página de migração do Dub.
Relacionados no blog
- Elido vs Dub: SSO, rastreamento de conversões, residência na UE
- Alternativas ao Dub: 6 plataformas de gerenciamento de links comparadas
- Entregando a migração do Bitly: um worker, um token, um orçamento de 30 minutos
- Entregando a migração do Rebrandly: paginação de 25 por página
- Entregando a migração do Short.io: paginação por domínio a 150 por página
Perguntas frequentes
O que o importador do Dub.co traz para o Elido?
Para cada link que lê, o importador traz o slug (a key do Dub), a URL de destino, o título (cortado em 200 caracteres) e os nomes das tags, e adiciona uma tag imported:dub. Nada mais é lido do registro do Dub: nem descrição, nem expiração, nem senha, nem campos UTM, nem regras de segmentação, nem contagem de cliques.
As minhas pastas do Dub sobrevivem à importação?
Não. O endpoint de listagem do Dub devolve apenas um folderId para cada link, não o nome da pasta, e o importador não consulta as pastas. Os links importados mantêm as tags, mas chegam sem nenhuma informação de pasta. Se você depende de pastas, anote qual tag ou padrão de slug corresponde a cada pasta antes de começar.
Os links arquivados do Dub são importados?
Não por padrão. O endpoint de listagem do Dub deixa de fora os links arquivados, a menos que um parâmetro showArchived seja enviado, e o importador não o envia. Desarquive o que quiser manter, ou recrie à mão, antes de executar a importação.
Posso limitar a importação a um workspace do Dub?
Uma chave de API do Dub pertence a um único workspace, então a própria chave já limita o que é listado. A API aceita um campo opcional workspace_id e o repassa ao Dub como parâmetro de consulta, mas os parâmetros de listagem documentados pelo Dub não o incluem. O formulário do painel não tem esse campo, então trate-o como uma operação sem efeito.
Quantos links uma execução importa e quanto tempo pode levar?
Uma execução para em 50.000 links ou 30 minutos, o que vier primeiro, e lê 100 links por requisição. Acima disso, o job é marcado como falho com uma mensagem de orçamento no ponto em que parou. Uma execução que não avança por 30 minutos também é varrida para o estado de falha.
O importador funciona com um Dub self-hosted?
Hoje não. A base da API está fixada em https://api.dub.co no código e não há configuração nem variável de ambiente para alterá-la. Uma instância self-hosted do Dub não pode ser apontada pelo painel. Exporte os seus links do seu próprio banco de dados e recrie-os pela API do Elido.
Experimente Elido
Cole uma URL, obtenha um link curto
Sem cadastro. O link vive 30 dias. Cadastre-se para mantê-lo para sempre.
Grátis, sem necessidade de registo · 2 por dia