
De Dub.co-importer van Elido leest je links via de REST API van Dub, 100 per verzoek, en maakt ze aan op één Elido-domein met dezelfde slug. Hij neemt de slug, bestemmings-URL, titel en tagnamen mee. Hij neemt geen mappen, gearchiveerde links, klikgeschiedenis of linkinstellingen mee. Dat zijn de feiten die tellen als je een verhuizing plant.
Een eerdere versie van dit artikel beweerde dat Dub-mappen worden platgeslagen tot tags. Ik heb de importer voor deze update opnieuw gelezen en dat klopte niet: de code leest mappen nooit. Deze versie beschrijft wat services/api-core/internal/imports/dub.go nu doet, gecontroleerd aan de hand van de gepubliceerde API-specificatie van Dub (geraadpleegd op 2026-10-02).
Wat de importer aan Dub vraagt
De worker stuurt GET https://api.dub.co/links?page=N&pageSize=100 met jouw key als bearer-token. Volgens de documentatie over API-keys van Dub (geraadpleegd op 2026-10-02) is een key aan één workspace gebonden en kan hij alleen-lezen worden aangemaakt. Een alleen-lezen key is alles wat deze import nodig heeft, omdat de worker alleen links opsomt en nooit naar Dub schrijft.
Het antwoord is een gewone JSON-array. Er is geen vlag "heeft meer", dus de worker blijft pagina's opvragen tot er een binnenkomt met minder dan 100 items, of een lege:
if len(links) == 0 { break }
// ... import each link ...
if len(links) < dubPageSize { break } // last page
page++
Eén kanttekening uit de eigen specificatie van Dub: de parameter page is als verouderd gemarkeerd ten gunste van cursorpaginering met startingAfter. Hij werkt nu nog, en pageSize accepteert tot 100. Als Dub page verwijdert, heeft de importer een kleine aanpassing nodig, en ik verwacht dat dat zich toont als een mislukte job met een duidelijke HTTP-fout in plaats van stil dataverlies.
De pagina over rate limits van Dub (geraadpleegd op 2026-10-02) noemt 60 verzoeken per minuut op het gratis abonnement en 600 op Pro. De importer voegt links tussen de verzoeken door één voor één in Postgres in, dus hij komt in de praktijk niet in de buurt van de gratis limiet. Hij heeft ook geen retry: een HTTP 429 of elk ander antwoord dan 200 beëindigt de job als mislukt, met de statuscode in de melding.
Wat in Elido terechtkomt, veld voor veld
| Dub-veld | In Elido | Opmerkingen |
|---|---|---|
key | Slug | Onderworpen aan de conflictstrategie hieronder |
url | Bestemmings-URL | Een link zonder URL of zonder key telt als mislukt |
title | Titel | Afgekapt op 200 tekens |
tags[].name | Tags | Alleen namen, kleuren gaan niet mee |
| (geen) | imported:dub-tag | Toegevoegd aan elke geïmporteerde link |
domain, folderId, archived, overige | Niet gelezen | Zie de volgende twee secties |
Al het andere op een Dub-link valt van tafel: beschrijving, voorbeeldafbeelding voor social media, vervaldatum, wachtwoord, geo- en apparaattargeting, UTM-velden, iOS- en Android-doelen, vlaggen voor conversietracking. Hangt een link van een van die zaken af, bouw hem dan na de import opnieuw op. Elido heeft eigen smartlinkregels voor targeting, maar niets zet de regels van Dub automatisch over.

Mappen, gearchiveerde links en domeinen
Drie Dub-concepten worden niet afgehandeld, en elk kan je verrassen.
Mappen. In het linkschema van Dub verschijnt een map alleen als een folderId-string. De importer heeft er geen veld voor en doet geen tweede aanroep om mapnamen op te lossen. Elido heeft tags, geen mappen, dus zelfs een toekomstige importer zou ze moeten platslaan. Nu gaat de mapstructuur verloren. Als dat ertoe doet, noteer dan de map bij elke slug voordat je begint, en tag daarna de geïmporteerde batch (filter op imported:dub) met de hand of via de API.
Gearchiveerde links. Het list-endpoint van Dub kent een parameter showArchived die standaard false is. De importer zet hem nooit, dus gearchiveerde links worden niet teruggegeven en niet geïmporteerd. Dat is een redelijke standaard voor een migratie, maar je moet het weten als je oude campagnelinks bewust gearchiveerd houdt.
Linkdomeinen. Een Dub-workspace kan links op meerdere domeinen bevatten. De importer leest ze allemaal, negeert het veld domain en maakt elke link aan op het ene Elido-domein dat je kiest. Als twee Dub-domeinen dezelfde key gebruiken, stuit de tweede op een conflict. De conflictstrategie bepaalt wat er dan gebeurt, dus kies hem met dat in gedachten.
Conflicten, limieten en het workercontract
Je kiest een conflictstrategie wanneer je de job start:
suffixprobeertmylink-2,mylink-3enzovoort tot-50, geeft die link dan op en telt hem als mislukt.skiplaat de bestaande Elido-link met rust en logt de slug als overgeslagen.failstopt de hele job bij het eerste conflict.
Per run stopt de worker bij 50.000 links (MaxLinksPerImport) of na 30 minuten (ImportRunBudget), wat het eerst komt. De voortgang wordt elke 50 links opgeslagen en het dashboard pollt hem. Het foutenlog bewaart maximaal 1.000 items. Elke slugcontrole is één geïndexeerde lookup op (domain_id, slug).
Ik heb Dub-imports niet gebenchmarkt tegen een groot account, dus ik noem geen cijfer voor links per minuut. De lus is één HTTP-pagina van 100 links gevolgd door 100 opeenvolgende inserts, dus de duur schaalt met hoe snel Dub antwoordt en met je database. Test eerst met een kleine workspace.
Tokenafhandeling en wat er bij een deploy gebeurt
De key reist mee in de requestbody van POST /imports/dub, wordt in het geheugen van de draaiende worker bewaard en wordt nooit opgeslagen: de source_token_id van de jobrij blijft leeg. Alleen de optionele workspace_id-tekst komt in de kolom source_filter van de job.
De worker draait in een goroutine die met context.WithoutCancel is losgekoppeld van het HTTP-verzoek. Dat houdt hem in leven na het antwoord, en het betekent ook dat een deploy of herstart hem halverwege een run beëindigt. Een schedulerjob draait elke 5 minuten en markeert elke running-import zonder voortgang gedurende 30 minuten als mislukt. Opnieuw draaien is veilig onder suffix (je krijgt -2-kopieën van alles wat al is geïmporteerd) en onder skip (reeds geïmporteerde slugs worden overgeslagen). Er wordt nog niets hervat vanaf de laatste pagina.
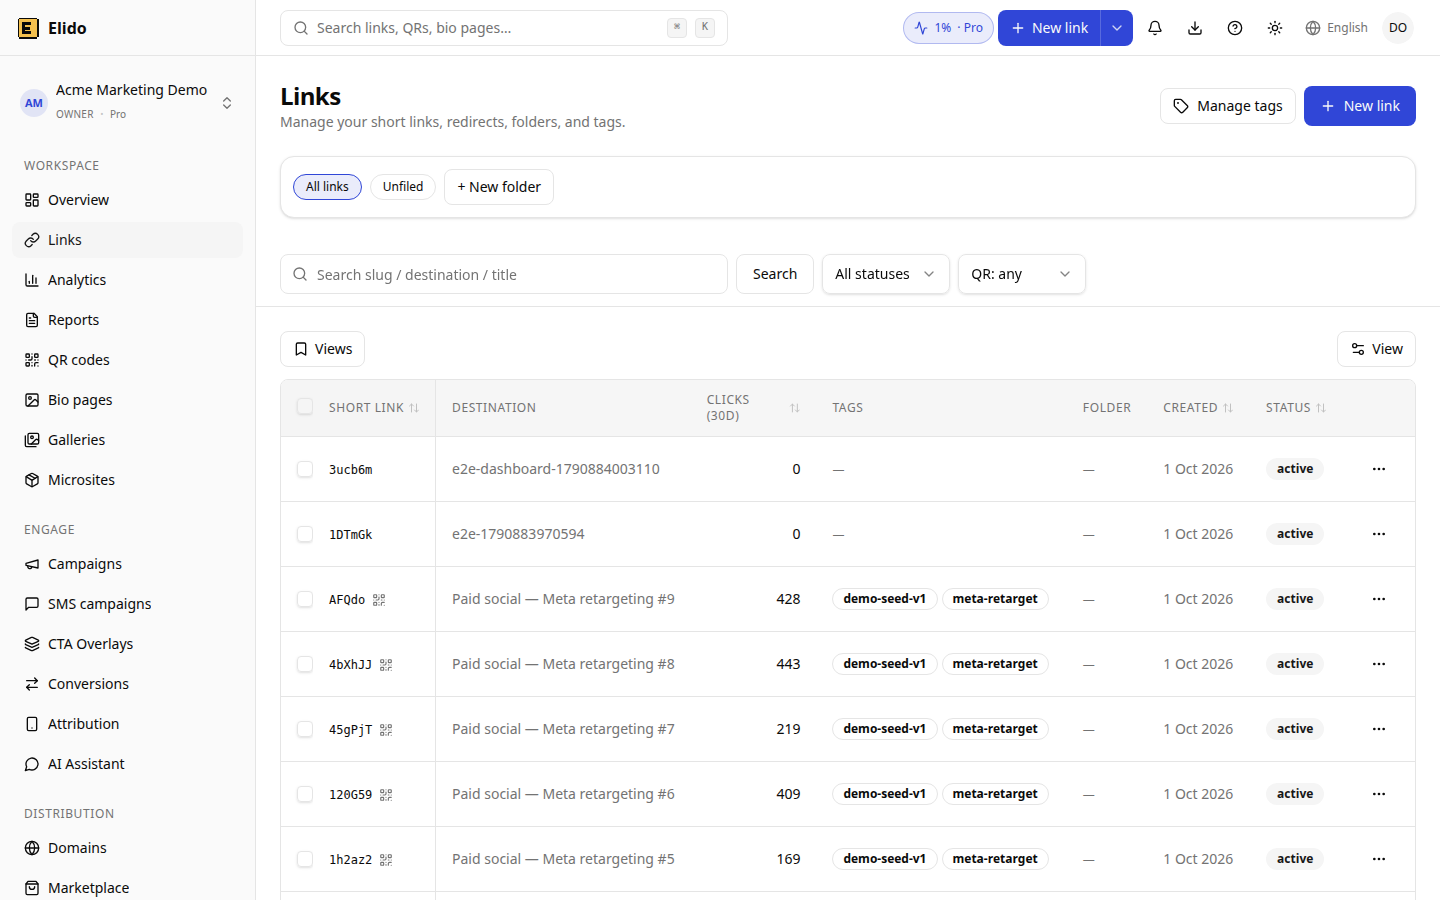
De linklijst in een demo-workspace met synthetische data. Filter na een import op de tag imported:dub om de batch te vinden.
Een korte checklist voordat je draait
- Maak een alleen-lezen API-key aan in je Dub-workspace.
- Haal gearchiveerde links die je wilt houden uit het archief en noteer de mapstructuur waarop je leunt.
- Voeg het doeldomein toe in Elido en kies
skipofsuffixin de wetenschap dat alle Dub-domeinen in dit ene domein samenvallen. - Draai de import vanaf de integratiepagina in het dashboard, of via
POST /imports/dubmettoken,target_domain_idenconflict_strategy. - Controleer steekproefsgewijs slugs en bestemmingen tegen Dub en werk daarna de DNS bij voor elk eigen domein dat je bezit. Het cutoverplaybook voor Bitly behandelt de DNS-volgorde, die voor elke leverancier hetzelfde is.
Als je nog twijfelt of je wel wilt verhuizen, vergelijkt Elido vs Dub abonnementen en functies, en legt GDPR voor URL-verkorters de kant van dataresidentie uit. De leveranciersgerichte uitleg staat op de Dub-migratiepagina.
Gerelateerd op de blog
- Elido vs Dub: SSO, conversietracking, EU-residentie
- Dub-alternatieven: 6 linkbeheerplatforms vergeleken
- De Bitly-migratie opleveren: een worker, een token, een budget van 30 minuten
- De Rebrandly-migratie opleveren: paginering met 25 per pagina
- De Short.io-migratie opleveren: paginering per domein met 150 per pagina
Veelgestelde vragen
Wat neemt de Dub.co-importer mee naar Elido?
Per link die hij leest neemt de importer de slug (de Dub-key), de bestemmings-URL, de titel (afgekapt op 200 tekens) en de tagnamen mee, en voegt hij een tag imported:dub toe. Verder wordt niets uit het Dub-record gelezen: geen beschrijving, vervaldatum, wachtwoord, UTM-velden, targetingregels of klikaantallen.
Blijven mijn Dub-mappen behouden bij de import?
Nee. Het list-endpoint van Dub geeft per link alleen een folderId terug, niet de mapnaam, en de importer zoekt mappen niet op. Geïmporteerde links behouden hun tags maar komen zonder mapinformatie binnen. Als je op mappen leunt, noteer dan welke tag of slugpatroon bij welke map hoort voordat je begint.
Worden gearchiveerde Dub-links geïmporteerd?
Standaard niet. Het list-endpoint van Dub laat gearchiveerde links weg tenzij een parameter showArchived wordt meegestuurd, en de importer stuurt die niet mee. Haal alles wat je wilt houden uit het archief, of maak het met de hand opnieuw aan, voordat je de import draait.
Kan ik de import beperken tot één Dub-workspace?
Een Dub-API-key hoort bij één workspace, dus de key beperkt al wat wordt opgesomd. De API accepteert een optioneel veld workspace_id en stuurt dat als queryparameter door naar Dub, maar de gedocumenteerde list-parameters van Dub bevatten het niet. Het dashboardformulier heeft zo'n veld niet, dus beschouw het als een no-op.
Hoeveel links kan één run importeren en hoe lang kan het duren?
Een run stopt bij 50.000 links of 30 minuten, wat het eerst komt, en leest 100 links per verzoek. Daarboven wordt de job als mislukt gemarkeerd met een budgetmelding op het punt waar hij stopte. Een run die 30 minuten geen voortgang boekt, wordt ook als mislukt opgeruimd.
Werkt de importer met een zelf gehoste Dub?
Op dit moment niet. De API-basis staat in de code vast op https://api.dub.co en er is geen instelling of omgevingsvariabele om dat te wijzigen. Een zelf gehoste Dub-instantie kun je niet via het dashboard aanwijzen. Exporteer je links uit je eigen database en maak ze opnieuw aan via de Elido-API.
Probeer Elido
Plak een URL, krijg een werkende korte link
Geen aanmelding nodig. Link blijft 30 dagen actief. Meld je aan om hem voor altijd te bewaren.
Gratis, geen aanmelding nodig · 2 per dag