
L'importeur de migration TinyURL prend un jeton d'API, un domaine Elido cible et une stratégie de conflit, puis copie vos liens TinyURL dans Elido sous forme d'une tâche d'arrière-plan. Il a un défaut connu et sérieux : il appelle GET /aliases sur api.tinyurl.com, et ce chemin ne figure pas dans l'API publiée de TinyURL. Cet article couvre ce que fait l'importeur, ce que nous avons vérifié et ce que nous n'avons pas vérifié.
Si vous voulez le guide pratique pour préparer un départ de TinyURL (ce qui peut être redirigé, la correspondance CSV, la liste de contrôle de bascule), lisez Migrer depuis TinyURL. Ici, c'est le côté ingénierie.
Le bug connu
La récupération de page de l'importeur construit cette requête :
GET https://api.tinyurl.com/aliases?page=1&per_page=100
Authorization: Bearer <token>
et attend en retour {"data": [{alias, url, title, tags}], "meta": {"total", "has_more"}}.
La spécification OpenAPI de TinyURL (consultée le 2026-10-02) ne définit aucun chemin /aliases. La liste se fait par GET /urls/{type}, où type vaut available ou archived, avec des filtres facultatifs from, to et search (un préfixe alias: ou tag:). La spécification ne définit ni paramètres page ou per_page, ni limites de débit. Les opérations sur les alias se trouvent sous /alias/{domain}/{alias}.
Le contrat de pagination de notre code n'a donc jamais été tiré de TinyURL. Notre test unitaire sert une réponse écrite à la main sous cette forme et passe, ce qui prouve que l'analyseur correspond à notre hypothèse et rien de plus sur TinyURL. Nous n'avons pas exécuté l'importeur sur un compte TinyURL réel, car cela exige un jeton d'un plan payant. D'ici là, ne planifiez pas une migration autour de lui. Le correctif est suivi dans notre backlog interne : passer à /urls/available (et /urls/archived derrière un indicateur), parcourir des fenêtres from/to, analyser de façon défensive et tester sur une vraie réponse capturée. Que la vraie réponse contienne une liste ou un objet unique, la spécification ne le précise pas.
Ce que fait le worker après avoir reçu une page
La page des intégrations dans un espace de travail DEMO avec des données synthétiques. La migration TinyURL se lance d'ici.
Tout ce qui suit l'appel HTTP est indépendant de la question du point de terminaison. Cette partie, nous pouvons l'affirmer d'après le code.
- Démarrage.
POSTavectoken,target_domain_idetconflict_strategyfacultatif. Le gestionnaire rejette un jeton vide, un domaine manquant et toute stratégie autre quesuffix,skip,fail, puis répond202avec la tâche et exécute le worker dans une goroutine d'arrière-plan détachée de la requête. - Par lien. Une ligne sans URL ou sans alias est comptée comme échouée avec une raison. Sinon l'alias devient le slug, la destination et le titre sont copiés (titre tronqué à 200 caractères), et les tags sont copiés avec
imported:tinyurlajouté. - Progression. Les compteurs sont écrits dans la ligne de la tâche tous les 50 liens. Au plus 1 000 lignes d'erreur sont consignées par tâche.
- Erreurs d'authentification et de débit. Un 401 ou 403 fait échouer la tâche avec un message « vérifiez le jeton bearer », un 429 la fait échouer comme limitée en débit. Il n'y a ni nouvelle tentative ni temporisation : la tâche s'arrête.
Règles de conflit
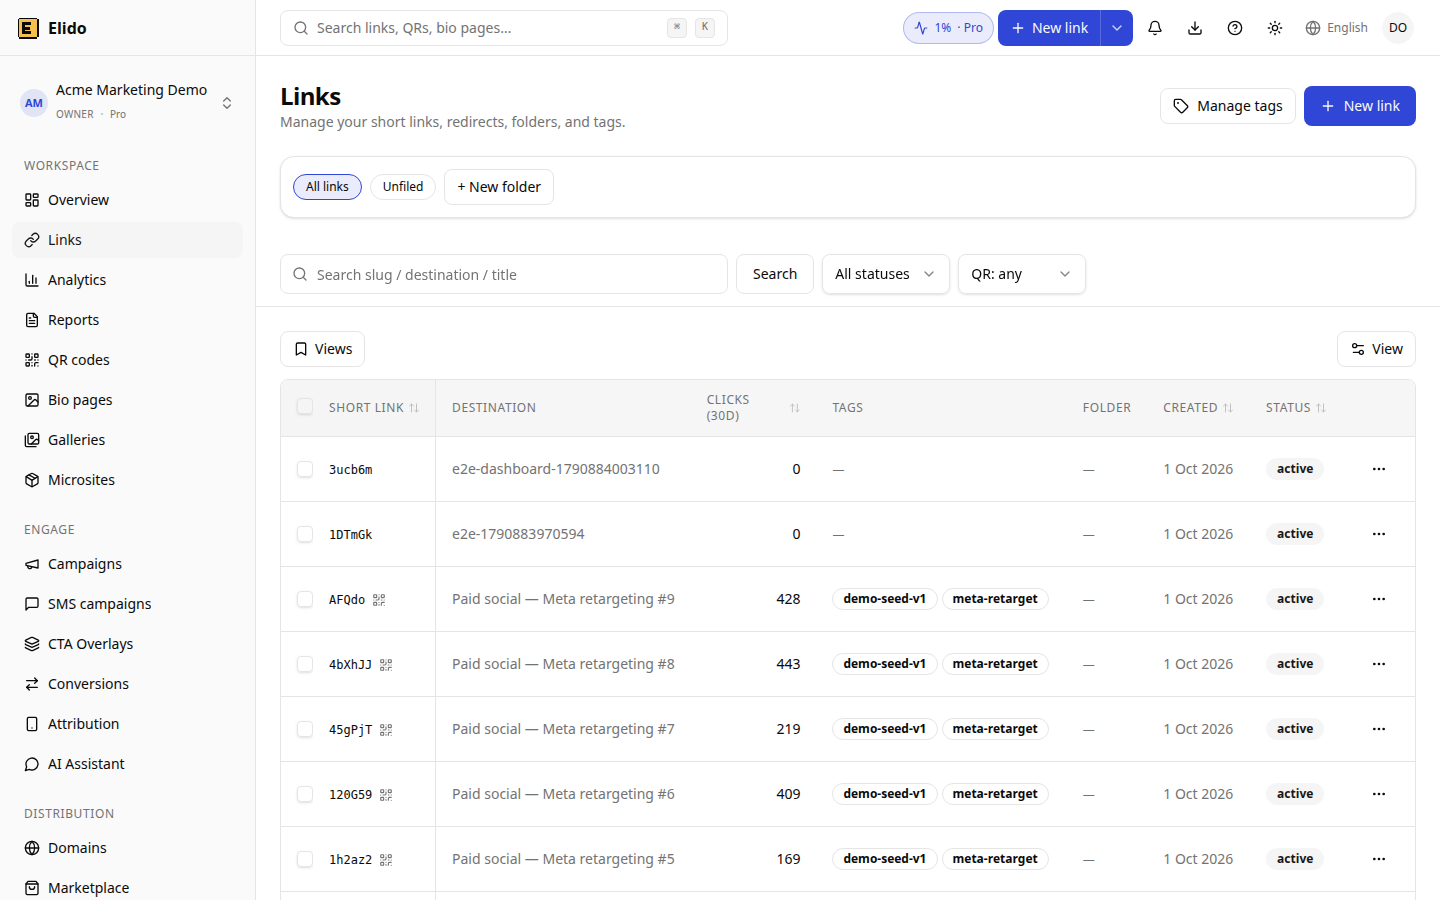
La liste des liens dans un espace de travail DEMO. Les liens importés portent le tag imported:tinyurl, ce qui permet de filtrer un lot pour le relire.
Avant chaque insertion, le worker effectue une recherche indexée sur (domain, slug).
- suffix (par défaut) essaie
alias-2,alias-3, jusqu'àalias-50, et fait échouer la ligne si tous sont pris. - skip laisse le lien Elido existant tranquille et consigne la ligne source.
- fail fait échouer la tâche au premier conflit.
TinyURL les appelle des alias, Elido les appelle des slugs. C'est la même chose : les caractères après l'hôte. Si votre domaine cible est vide, les alias sont repris tels quels.
Plafonds
Un seul jeu de constantes partagé par tous les fournisseurs de migration : 50 000 liens par passage, un budget de 30 minutes, progression tous les 50 liens, 1 000 erreurs consignées.
Deux comportements méritent d'être connus. Quand le plafond de 50 000 est atteint, la boucle s'arrête simplement et la tâche se termine ; elle n'échoue pas et ne vous dit de contacter personne. Comparez les totaux finaux avec le total de votre source. Quand le budget de 30 minutes est épuisé, la tâche est marquée en échec avec le nombre de liens importés jusque-là.
Le worker vit dans api-core. Un déploiement ou un plantage en cours de passage le tue, et un balayage exécuté toutes les cinq minutes fait passer à failed les tâches sans progression depuis 30 minutes. Il n'y a pas de curseur enregistré : vous relancez donc la tâche. Relancer est sans danger avec suffix ou skip, mais avec suffix cela créera des copies -2 des liens que le premier passage a déjà écrits ; préférez donc skip pour une relance.
Gestion du jeton
Le jeton va du corps de la requête à la goroutine et nulle part ailleurs. La ligne de la tâche n'enregistre aucun jeton, et rien n'est chiffré au repos parce que rien n'est stocké. Le corps de la requête est lu avec une limite de 4 Ko.
Ce que le code ne fait pas : il ne valide pas le jeton avant de démarrer et ne vérifie pas le plan. Un mauvais jeton se manifeste par une tâche en échec après la première requête, pas par une erreur de formulaire. Des versions antérieures de cet article décrivaient une étape de contrôle préalable sur un point de terminaison de domaines. Cette étape n'existe pas dans le code, et la spécification de TinyURL n'a pas non plus un tel chemin.
Ce qui n'est pas migré
- Historique de clics. L'importeur ne lit que les champs des liens. Les nouveaux clics comptent à partir du moment où un lien est actif dans Elido.
- Style des QR codes, modèles, réglages de domaine de marque. Non lus. Un nom d'hôte de marque est une étape distincte : ajoutez-le comme domaine Elido et modifiez le DNS, voir domaines personnalisés pour les liens courts.
- Liens sans compte. Aucun jeton ne peut les lister.
L'importeur ne crée pas le domaine pour vous, ne gère pas le champ domain de TinyURL et n'a pas de téléversement CSV propre. Pour les migrations par fichier, utilisez le formulaire d'import en masse ou le pas-à-pas dans import en masse depuis Google Sheets.
Le tester et le contourner
Deux sections pratiques suivent. Tester l'importeur. Migrer sans lui.
Une façon sûre de vérifier un import
Dès que le point de terminaison est corrigé, ou si vous testez l'importeur vous-même avant, procédez petit. Créez un espace de travail jetable, ajoutez un domaine vide et lancez la tâche d'abord avec la stratégie fail. Un domaine vide signifie aucun conflit, donc tout échec est un problème d'analyse ou d'authentification plutôt qu'une collision. Comparez ensuite trois chiffres : le nombre source dans TinyURL, le total que la tâche rapporte, et les compteurs importés plus ignorés plus échoués. Comme le worker prend meta.total dans la réponse qu'il attend, un écart entre total et votre vrai nombre est le premier signe que la forme de la réponse diffère de ce que suppose l'analyseur.
Filtrez ensuite la liste des liens par imported:tinyurl et ouvrez dix liens au hasard. Vérifiez la destination, le slug et le titre par rapport à TinyURL. Ensuite, passez à skip pour toute relance.
Comment exporter depuis TinyURL sans l'importeur
L'appel de liste documenté est GET /urls/available avec un jeton bearer, et GET /urls/archived pour les liens archivés. Restreignez le résultat avec des dates-heures from et to si le compte est volumineux, puisque la spécification ne donne aucun paramètre de pagination. Écrivez la sortie dans un fichier avant toute autre chose, réduisez-la à destination, slug, title et chargez-la avec le formulaire en masse. Les détails de cette correspondance se trouvent dans le guide pratique. Nous n'avons pas non plus vérifié la forme de la réponse réelle ; inspectez donc une réponse à la main avant d'écrire un script dessus.
La suite
La séquence est : corriger le point de terminaison, ajouter une vraie réponse capturée comme jeu de test, puis revérifier chaque chiffre dans le guide pratique et sur la page d'atterrissage de migration. La pagination et la vraie limite par requête doivent être re-mesurées sur un compte réel, car la spécification ne donne ni l'une ni l'autre. Si vous devez quitter TinyURL avant cela, comparez les options dans Elido vs TinyURL et alternatives à TinyURL, et utilisez la voie CSV.
Sur le même sujet
Questions fréquentes
L'importeur TinyURL d'Elido fonctionne-t-il aujourd'hui ?
Considérez-le comme non vérifié. Le worker demande GET /aliases?page=N&per_page=100 sur api.tinyurl.com. La spécification OpenAPI de TinyURL (consultée le 2026-10-02) n'a aucun chemin /aliases ; les liens sont listés par GET /urls/{type}. Le test unitaire livré ne vérifie que la forme de réponse que nous avions supposée. Un correctif figure dans notre backlog, et d'ici là la voie fiable est un CSV ou un collage en masse.
Que copie l'importeur de chaque lien TinyURL ?
L'URL de destination, l'alias (utilisé comme slug), le titre et les tags, plus un tag imported:tinyurl sur chaque lien créé. Il ne copie ni l'historique de clics, ni le style des QR codes, ni rien d'autre.
Que se passe-t-il quand un alias existe déjà dans Elido ?
Vous choisissez une stratégie par tâche. Suffix essaie alias-2, alias-3 et ainsi de suite jusqu'à alias-50, skip laisse le lien existant et consigne la ligne, fail marque la tâche en échec au premier conflit. La valeur par défaut est suffix.
Mon jeton TinyURL est-il stocké ?
Non. La requête de démarrage transmet le jeton à une goroutine d'arrière-plan, et la ligne de la tâche ne stocke aucune référence au jeton. Le jeton n'existe en mémoire du processus que pendant le passage.
Y a-t-il une limite au nombre de liens qu'un import traite ?
Oui. Un passage s'arrête après 50 000 liens ou 30 minutes, selon ce qui arrive en premier. À la limite de liens, la tâche se termine comme terminée avec les 50 000 premiers traités ; comparez donc les totaux avec votre source.
Puis-je migrer depuis un compte TinyURL gratuit ?
TinyURL lie la liste des liens à un jeton d'API, et les liens créés sans connexion n'appartiennent à aucun compte, il n'y a donc rien à lister. Reconstituez vous-même une liste de destinations et utilisez l'import en masse.
Essayer Elido
Collez une URL, obtenez un lien court
Sans inscription. Lien actif 30 jours. Inscrivez-vous pour le garder pour toujours.
Gratuit, sans inscription · 2 par jour
Lire la suite
- IngénierieLancement de la migration depuis Rebrandly : pagination de 25 éléments par page et budget de 30 minutes
- IngénierieLivraison de la migration Bitly : un worker, un token, un budget de 30 minutes
- IngénierieL'encodage d'URL expliqué : quels caractères échapper
- IngénierieGérer vos liens courts comme du Terraform