
L'importeur Dub.co d'Elido lit vos liens via l'API REST de Dub, 100 par requête, et les crée sur un domaine Elido avec le même slug. Il reprend le slug, l'URL de destination, le titre et les noms de tags. Il ne reprend ni les dossiers, ni les liens archivés, ni l'historique de clics, ni aucun réglage de lien. Ce sont les faits qui comptent si vous planifiez un déménagement.
Une version antérieure de cet article affirmait que les dossiers Dub s'aplatissent en tags. J'ai relu l'importeur pour cette mise à jour et c'était faux : le code ne lit jamais les dossiers. Cette version décrit ce que fait aujourd'hui services/api-core/internal/imports/dub.go, vérifié par rapport à la spécification d'API publiée par Dub (consultée le 2026-10-02).
Ce que l'importeur demande à Dub
Le worker envoie GET https://api.dub.co/links?page=N&pageSize=100 avec votre clé comme jeton bearer. D'après la documentation des clés d'API de Dub (consultée le 2026-10-02), une clé est liée à un seul espace de travail et peut être créée en lecture seule. Une clé en lecture seule suffit pour cet import, car le worker ne fait que lister les liens et n'écrit jamais dans Dub.
La réponse est un simple tableau JSON. Il n'y a pas d'indicateur « page suivante », donc le worker continue de demander des pages jusqu'à ce que l'une revienne avec moins de 100 éléments, ou vide :
if len(links) == 0 { break }
// ... import each link ...
if len(links) < dubPageSize { break } // last page
page++
Une réserve tirée de la spécification de Dub elle-même : le paramètre page est marqué comme obsolète au profit de la pagination par curseur avec startingAfter. Il fonctionne encore aujourd'hui, et pageSize accepte jusqu'à 100. Si Dub supprime page, l'importeur nécessitera une petite modification, et je m'attends à ce que cela se manifeste par une tâche en échec avec une erreur HTTP claire plutôt que par une perte silencieuse de données.
La page des limites de débit de Dub (consultée le 2026-10-02) indique 60 requêtes par minute sur le plan Free et 600 sur Pro. L'importeur insère les liens un par un dans Postgres entre les requêtes, donc il n'approche pas la limite Free en pratique. Il n'a pas non plus de nouvelle tentative : une réponse HTTP 429 ou toute réponse autre que 200 termine la tâche en échec avec le code de statut dans le message.
Ce qui arrive dans Elido, champ par champ
| Champ Dub | Dans Elido | Notes |
|---|---|---|
key | Slug | Soumis à la stratégie de conflit ci-dessous |
url | URL de destination | Un lien sans URL ou sans clé est compté comme échoué |
title | Titre | Tronqué à 200 caractères |
tags[].name | Tags | Noms uniquement, les couleurs ne sont pas reprises |
| (aucun) | Tag imported:dub | Ajouté à chaque lien importé |
domain, folderId, archived, autres | Non lus | Voir les deux sections suivantes |
Tout le reste d'un lien Dub est abandonné : description, image d'aperçu social, expiration, mot de passe, ciblage géographique et par appareil, champs UTM, cibles iOS et Android, indicateurs de suivi des conversions. Si un lien dépend de l'un de ces éléments, reconstruisez-le après l'import. Elido a ses propres règles de liens intelligents pour le ciblage, mais rien ne transpose automatiquement les règles de Dub.

Dossiers, liens archivés et domaines
Trois concepts de Dub ne sont pas gérés, et chacun peut vous surprendre.
Dossiers. Dans le schéma de lien de Dub, un dossier n'apparaît que sous forme d'une chaîne folderId. L'importeur n'a pas de champ pour cela et ne fait aucun second appel pour résoudre les noms de dossiers. Elido a des tags, pas des dossiers, donc même un futur importeur devrait les aplatir. Aujourd'hui, la structure des dossiers est perdue. Si elle compte, notez le dossier de chaque slug avant de commencer, puis taguez le lot importé (filtrez sur imported:dub) à la main ou avec l'API.
Liens archivés. Le point de terminaison de liste de Dub accepte un paramètre showArchived dont la valeur par défaut est false. L'importeur ne le définit jamais, donc les liens archivés ne sont ni renvoyés ni importés. C'est une valeur par défaut raisonnable pour une migration, mais vous devez le savoir si vous gardez volontairement d'anciens liens de campagne archivés.
Domaines de liens. Un espace de travail Dub peut contenir des liens sur plusieurs domaines. L'importeur les lit tous, ignore le champ domain et crée chaque lien sur l'unique domaine Elido que vous choisissez. Si deux domaines Dub utilisent la même clé, le second entre en conflit. La stratégie de conflit décide de la suite ; choisissez-la donc en conséquence.
Conflits, plafonds et contrat du worker
Vous choisissez une stratégie de conflit au démarrage de la tâche :
suffixessaiemylink-2,mylink-3et ainsi de suite jusqu'à-50, puis abandonne ce lien et le compte comme échoué.skiplaisse le lien Elido existant tranquille et consigne le slug comme ignoré.failarrête toute la tâche au premier conflit.
Par passage, le worker s'arrête à 50 000 liens (MaxLinksPerImport) ou après 30 minutes (ImportRunBudget), selon ce qui arrive en premier. La progression est enregistrée tous les 50 liens et le tableau de bord l'interroge. Le journal d'erreurs conserve au plus 1 000 entrées. Chaque vérification de slug est une recherche indexée sur (domain_id, slug).
Je n'ai pas testé les performances des imports Dub sur un gros compte, donc je ne citerai pas de chiffre de liens par minute. La boucle est une page HTTP de 100 liens suivie de 100 insertions séquentielles ; la durée dépend donc de la vitesse de réponse de Dub et de votre base de données. Testez d'abord avec un petit espace de travail.
Gestion du jeton et ce qui se passe lors d'un déploiement
La clé voyage dans le corps de la requête de POST /imports/dub, est conservée dans la mémoire du worker en cours d'exécution et n'est jamais stockée : le source_token_id de la ligne de la tâche reste vide. Seul le texte facultatif workspace_id va dans la colonne source_filter de la tâche.
Le worker s'exécute dans une goroutine détachée de la requête HTTP avec context.WithoutCancel. Cela le garde en vie après la réponse, et cela signifie aussi qu'un déploiement ou un redémarrage le tue en plein passage. Une tâche du planificateur s'exécute toutes les 5 minutes et marque comme échoué tout import running sans progression depuis 30 minutes. Relancer est sans danger avec suffix (vous obtenez des copies -2 de tout ce qui a déjà été importé) et avec skip (les slugs déjà importés sont ignorés). Rien ne reprend encore à partir de la dernière page.
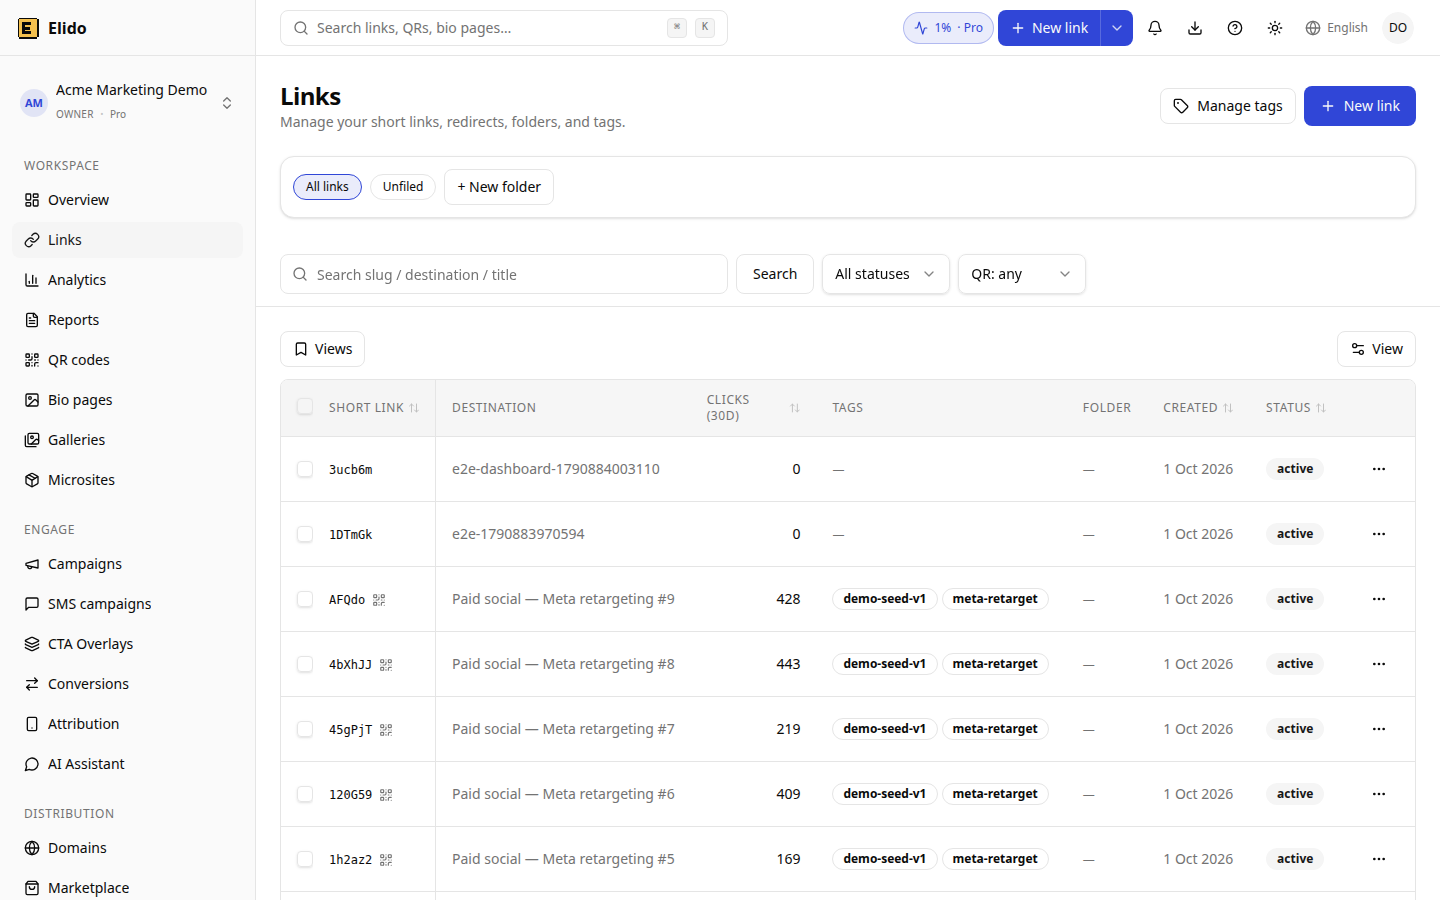
La liste des liens dans un espace de travail de démonstration avec des données synthétiques. Après un import, filtrez sur le tag imported:dub pour retrouver le lot.
Une courte liste de contrôle avant de lancer
- Créez une clé d'API en lecture seule dans votre espace de travail Dub.
- Désarchivez les liens archivés que vous voulez conserver, et notez toute structure de dossiers sur laquelle vous vous appuyez.
- Ajoutez le domaine cible dans Elido, et choisissez
skipousuffixen sachant que tous les domaines Dub se fondent en un seul. - Lancez l'import depuis la page d'intégration du tableau de bord, ou
POST /imports/dubavectoken,target_domain_idetconflict_strategy. - Vérifiez par sondage les slugs et les destinations par rapport à Dub, puis mettez à jour le DNS de tout domaine personnalisé que vous possédez. Le guide de bascule depuis Bitly détaille l'ordre des opérations DNS, identique pour tout fournisseur.
Si vous hésitez encore à déménager, Elido vs Dub compare les plans et les fonctionnalités, et le RGPD pour les raccourcisseurs d'URL explique le volet résidence des données. La marche à suivre côté fournisseur se trouve sur la page de migration Dub.
Sur le même sujet
- Elido vs Dub : SSO, suivi des conversions, résidence UE
- Alternatives à Dub : 6 plateformes de gestion de liens comparées
- Livraison de la migration Bitly : un worker, un jeton, un budget de 30 minutes
- Livraison de la migration Rebrandly : pagination à 25 par page
- Livraison de la migration Short.io : pagination par domaine à 150 par page
Questions fréquentes
Que reprend l'importeur Dub.co dans Elido ?
Pour chaque lien lu, l'importeur reprend le slug (la clé Dub), l'URL de destination, le titre (tronqué à 200 caractères) et les noms de tags, et ajoute un tag imported:dub. Rien d'autre n'est lu dans l'enregistrement Dub : ni description, ni expiration, ni mot de passe, ni champs UTM, ni règles de ciblage, ni nombre de clics.
Mes dossiers Dub survivent-ils à l'import ?
Non. Le point de terminaison de liste de Dub ne renvoie qu'un folderId pour chaque lien, pas le nom du dossier, et l'importeur ne recherche pas les dossiers. Les liens importés conservent leurs tags mais arrivent sans information de dossier. Si vous vous appuyez sur les dossiers, notez quel tag ou quel motif de slug correspond à chaque dossier avant de commencer.
Les liens Dub archivés sont-ils importés ?
Pas par défaut. Le point de terminaison de liste de Dub exclut les liens archivés sauf si un paramètre showArchived est envoyé, et l'importeur ne l'envoie pas. Désarchivez ce que vous voulez conserver, ou recréez-le à la main, avant de lancer l'import.
Puis-je limiter l'import à un seul espace de travail Dub ?
Une clé d'API Dub appartient à un seul espace de travail, donc la clé limite déjà ce qui est listé. L'API accepte un champ facultatif workspace_id et le transmet à Dub comme paramètre de requête, mais les paramètres de liste documentés par Dub ne l'incluent pas. Le formulaire du tableau de bord n'a pas ce champ ; considérez-le donc comme sans effet.
Combien de liens un passage peut-il importer, et combien de temps cela peut-il prendre ?
Un passage s'arrête à 50 000 liens ou 30 minutes, selon ce qui arrive en premier, et lit 100 liens par requête. Au-delà, la tâche est marquée en échec avec un message de budget à l'endroit où elle s'est arrêtée. Un passage qui ne progresse pas pendant 30 minutes est aussi balayé et marqué en échec.
L'importeur fonctionne-t-il avec un Dub auto-hébergé ?
Pas aujourd'hui. La base de l'API est fixée à https://api.dub.co dans le code et aucun réglage ni variable d'environnement ne permet de la changer. Une instance Dub auto-hébergée ne peut pas être ciblée depuis le tableau de bord. Exportez vos liens depuis votre propre base de données et recréez-les via l'API d'Elido.
Essayer Elido
Collez une URL, obtenez un lien court
Sans inscription. Lien actif 30 jours. Inscrivez-vous pour le garder pour toujours.
Gratuit, sans inscription · 2 par jour
Lire la suite
- IngénierieChaîne de redirections et SEO : combien de sauts sont de trop ?
- IngénierieGénération de codes courts : base62, hachage ou codes aléatoires
- IngénierieAutorisations des clés API : le principe du moindre privilège pour les outils de liens
- IngénierieVérifier les signatures des webhooks : HMAC-SHA256 avec Node, Python et Go