
Імпортер Dub.co в Elido читає ваші посилання через REST API Dub, по 100 за запит, і створює їх на одному домені Elido з тим самим slug. Він переносить slug, URL призначення, заголовок і назви тегів. Він не переносить папки, архівні посилання, історію кліків чи будь-які налаштування посилань. Це ті факти, що мають значення, якщо ви плануєте міграцію.
Свого часу ця стаття стверджувала, що папки Dub згортаються в теги. Для цього оновлення я перечитав імпортер, і це було хибно: код папки взагалі не читає. Ця версія описує, що services/api-core/internal/imports/dub.go робить сьогодні, звірено з опублікованою специфікацією API Dub (доступ 2026-10-02).
Що імпортер просить у Dub
Воркер надсилає GET https://api.dub.co/links?page=N&pageSize=100 з вашим ключем як bearer-токеном. Згідно з документацією Dub щодо ключів API (доступ 2026-10-02), ключ прив'язаний до одного робочого простору й може бути створений лише для читання. Ключа лише для читання цілком досить для цього імпорту, бо воркер лише перелічує посилання й ніколи нічого не пише в Dub.
Відповідь - звичайний масив JSON. Прапорця «є ще» немає, тож воркер запитує сторінки, доки не прийде сторінка коротша за 100 елементів або порожня:
if len(links) == 0 { break }
// ... import each link ...
if len(links) < dubPageSize { break } // last page
page++
Одне застереження зі специфікації самого Dub: параметр page позначено застарілим на користь курсорної пагінації через startingAfter. Він і досі працює, а pageSize приймає до 100. Якщо Dub прибере page, імпортер потребуватиме невеликої зміни, і я очікую, що це проявиться як невдале завдання з чіткою помилкою HTTP, а не як тиха втрата даних.
На сторінці лімітів запитів Dub (доступ 2026-10-02) вказано 60 запитів на хвилину на плані Free і 600 на Pro. Між запитами імпортер вставляє посилання по одному в Postgres, тож на практиці до ліміту Free він не наближається. Повторних спроб він також не має: HTTP 429 або будь-яка відповідь не 200 завершує завдання як невдале з кодом статусу в повідомленні.
Що потрапляє в Elido, поле за полем
| Поле Dub | В Elido | Примітки |
|---|---|---|
key | Slug | Підлягає стратегії конфліктів нижче |
url | URL призначення | Посилання без URL або без ключа рахується як невдале |
title | Заголовок | Обрізається до 200 символів |
tags[].name | Теги | Лише назви, кольори не переносяться |
| (немає) | Тег imported:dub | Додається до кожного імпортованого посилання |
domain, folderId, archived, інші | Не читаються | Див. наступні два розділи |
Усе інше на посиланні Dub відкидається: опис, зображення соціального прев'ю, термін дії, пароль, гео- та девайс-таргетинг, поля UTM, цілі для iOS і Android, прапорці відстеження конверсій. Якщо посилання залежить від чогось із цього, відновіть його після імпорту. В Elido є власні правила розумних посилань для таргетингу, але ніщо не переносить правила Dub автоматично.

Папки, архівні посилання і домени
Три поняття Dub не обробляються, і кожне може здивувати.
Папки. У схемі посилання Dub папка з'являється лише як рядок folderId. В імпортера немає для нього поля, і він не робить другого виклику, щоб визначити назви папок. В Elido є теги, а не папки, тож навіть майбутній імпортер мав би їх згортати. Сьогодні структура папок губиться. Якщо це важливо, занотуйте папку для кожного slug перед початком, а потім позначте тегами імпортовану партію (фільтруйте за imported:dub) вручну або через API.
Архівні посилання. Endpoint списку Dub приймає параметр showArchived, який типово дорівнює false. Імпортер його ніколи не виставляє, тож архівні посилання не повертаються й не імпортуються. Це розумне типове значення для міграції, але варто знати про нього, якщо ви навмисно тримаєте старі кампанійні посилання в архіві.
Домени посилань. Робочий простір Dub може містити посилання на кількох доменах. Імпортер читає всі, ігнорує поле domain і створює кожне посилання на єдиному домені Elido, який ви обрали. Якщо два домени Dub використовують однаковий ключ, другий потрапляє в конфлікт. Що буде далі, вирішує стратегія конфліктів, тож обирайте її з урахуванням цього.
Конфлікти, ліміти і контракт воркера
Стратегію конфліктів ви обираєте під час запуску завдання:
suffixпробуєmylink-2,mylink-3і так далі до-50, а тоді відмовляється від цього посилання й рахує його як невдале.skipне чіпає наявне посилання Elido й записує slug як пропущений.failзупиняє все завдання на першому конфлікті.
За один запуск воркер зупиняється на 50 000 посилань (MaxLinksPerImport) або через 30 хвилин (ImportRunBudget), залежно від того, що настане раніше. Прогрес зберігається кожні 50 посилань, і панель його опитує. Журнал помилок зберігає щонайбільше 1000 записів. Кожна перевірка slug - це один індексований пошук за (domain_id, slug).
Я не робив бенчмарків імпорту Dub на великому акаунті, тож не наводитиму швидкість у посиланнях за хвилину. Цикл - це одна HTTP-сторінка зі 100 посилань і 100 послідовних вставок, тож тривалість залежить від швидкості відповіді Dub і від вашої бази даних. Спершу протестуйте на малому робочому просторі.
Обробка токена і що буває під час деплою
Ключ подорожує в тілі запиту POST /imports/dub, живе в пам'яті запущеного воркера й ніколи не зберігається: source_token_id у рядку завдання лишається порожнім. До стовпця source_filter завдання потрапляє лише необов'язковий текст workspace_id.
Воркер працює в горутині, відокремленій від HTTP-запиту через context.WithoutCancel. Це тримає його живим після відповіді, а також означає, що деплой або перезапуск убиває його посеред запуску. Завдання планувальника кожні 5 хвилин позначає як невдалий будь-який імпорт у стані running без прогресу 30 хвилин. Повторний запуск безпечний при suffix (ви отримаєте копії з -2 для всього вже імпортованого) і при skip (уже імпортовані slug пропускаються). Відновлення з останньої сторінки поки немає.
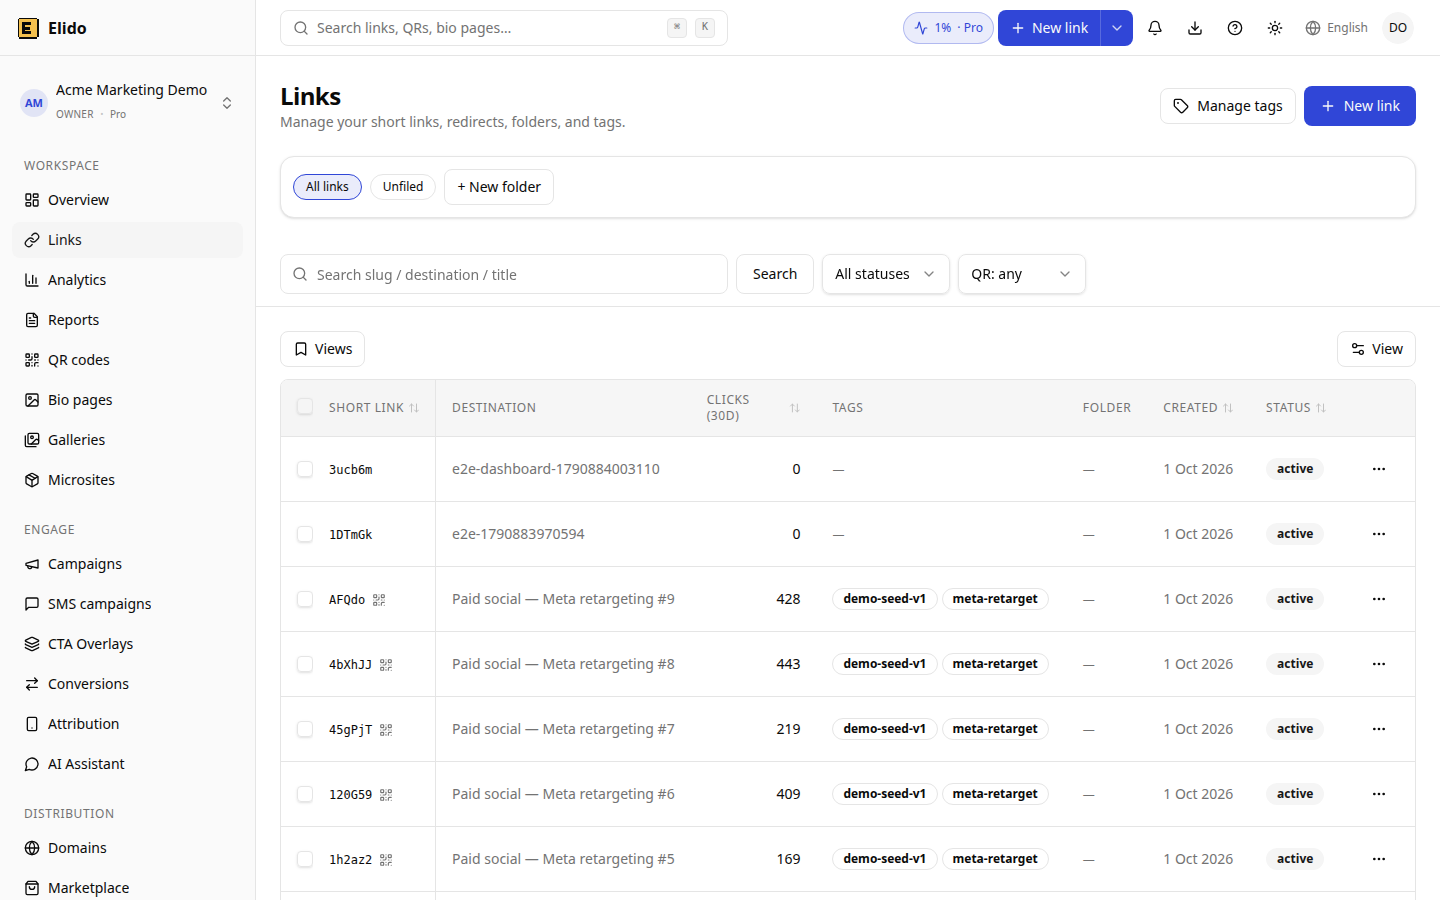
Список посилань у демо-просторі із синтетичними даними. Після імпорту фільтруйте за тегом imported:dub, щоб знайти партію.
Короткий чекліст перед запуском
- Створіть ключ API лише для читання у своєму робочому просторі Dub.
- Розархівуйте архівні посилання, які хочете зберегти, і занотуйте структуру папок, на яку покладаєтеся.
- Додайте цільовий домен в Elido та оберіть
skipабоsuffix, знаючи, що всі домени Dub зіллються в цей один. - Запустіть імпорт зі сторінки інтеграції на панелі або
POST /imports/dubзtoken,target_domain_idіconflict_strategy. - Вибірково звірте slug і призначення з Dub, а тоді оновіть DNS для будь-якого власного домену. Плейбук переходу з Bitly описує порядок змін DNS, який однаковий для будь-якого вендора.
Якщо ви ще вирішуєте, чи переїжджати взагалі, Elido проти Dub порівнює плани й функції, а GDPR для скорочувачів URL пояснює бік резиденції даних. Покрокова інструкція від вендора живе на сторінці міграції з Dub.
Читайте також у блозі
- Elido проти Dub: SSO, відстеження конверсій, резиденція в ЄС
- Альтернативи Dub: порівняння 6 платформ керування посиланнями
- Випуск міграції з Bitly: воркер, токен, бюджет 30 хвилин
- Випуск міграції з Rebrandly: пагінація по 25 на сторінку
- Випуск міграції з Short.io: пагінація по домену зі 150 на сторінку
Поширені запитання
Що імпортер Dub.co переносить в Elido?
Для кожного прочитаного посилання імпортер переносить slug (ключ Dub), URL призначення, заголовок (обрізаний до 200 символів) і назви тегів, а також додає тег imported:dub. Більше нічого із запису Dub не читається: ні опису, ні терміну дії, ні пароля, ні полів UTM, ні правил таргетингу, ні кількості кліків.
Чи зберігаються мої папки Dub після імпорту?
Ні. Endpoint списку в Dub повертає для кожного посилання лише folderId, а не назву папки, і імпортер не шукає папки. Імпортовані посилання зберігають теги, але приходять без інформації про папки. Якщо ви покладаєтеся на папки, перед початком запишіть, який тег або шаблон slug відповідає кожній папці.
Чи імпортуються архівні посилання Dub?
Типово ні. Endpoint списку в Dub пропускає архівні посилання, якщо не надіслано параметр showArchived, а імпортер його не надсилає. Розархівуйте все, що хочете зберегти, або створіть вручну, перш ніж запускати імпорт.
Чи можна обмежити імпорт одним робочим простором Dub?
Ключ API Dub належить одному робочому простору, тож ключ уже обмежує те, що потрапляє до списку. API приймає необов'язкове поле workspace_id і передає його в Dub як параметр запиту, але задокументовані параметри списку Dub його не містять. Форма на панелі такого поля не має, тож вважайте його порожньою операцією.
Скільки посилань може імпортувати один запуск і скільки це може тривати?
Запуск зупиняється на 50 000 посилань або через 30 хвилин, залежно від того, що настане раніше, і читає 100 посилань за запит. Понад це завдання позначається як невдале з повідомленням про бюджет у точці зупинки. Запуск, що не робить прогресу 30 хвилин, також переводиться в невдалий.
Чи працює імпортер із самостійно розміщеним Dub?
Сьогодні ні. База API жорстко зафіксована як https://api.dub.co у коді, і немає ні налаштування, ні змінної середовища, щоб це змінити. Самостійно розміщений екземпляр Dub не можна вказати через панель. Експортуйте посилання зі своєї бази даних і створіть їх заново через API Elido.
Спробуйте Elido
Вставте URL - отримайте коротке посилання
Без реєстрації. Посилання живе 30 днів. Зареєструйтесь, щоб зберегти назавжди.
Безкоштовно, без реєстрації · 2 на день