Ein URL-Redirect-Cache ist die Schicht, die "Wohin zeigt dieser Slug?" beantwortet, ohne jedes Mal die Datenbank zu fragen. Unserer hat zwei Stufen vor dem Origin: ein kleines LRU im Prozess, das 60 Sekunden lebt, und einen gemeinsamen Redis-Cache, der 5 Minuten lebt. Wenn beide verfehlen, fragt der Edge den Origin und füllt auf dem Rückweg beide.
Das ist das ganze Design, und die Zahlen zählen mehr als die Form. Dieser Beitrag geht durch die Stufen, die TTLs, die wir heute fahren, wie eine Änderung beide Stufen leert (und was passiert, wenn das scheitert), und den anderen Redirect-Cache, den die meisten meinen, wenn sie danach suchen: den im Browser. Der Cornerstone zu Redirect-p95 behandelt das gesamte Latenzbudget. Dies ist das Cache-spezifische Stück.
Ich habe die erste Version dieses Beitrags mit mehr Zuversicht geschrieben, als der Code verdiente. Ich habe ihn gegen den tatsächlichen Edge-Service neu geschrieben, daher beschreibt alles unten, was jetzt läuft, einschließlich der Teile, die wir verbessern möchten.
Warum ein Redirect überhaupt einen Cache braucht
Ein Redirect macht eine Abfrage: Host plus Slug hinein, Ziel und Regeln heraus. Nichts anderes gehört auf den Request-Pfad. Ziel, Status, Ablauf, Targeting-Regeln und Klick-Limit stehen im Link-Datensatz, und dieser liegt in Postgres hinter der Origin-API.
Den Origin pro Klick aufzurufen ist die langsame, fragile Option. Jeder Origin-Aufruf fügt dem Request einen Netzwerk-Hop hinzu, und ein Datenbank-Schluckauf würde zu einem Redirect-Ausfall. Also hält der Edge aktuelle Datensätze in der Nähe und behandelt den Origin als letzte Instanz. Für den Nutzer ist das sichtbare Ergebnis ein Redirect, der nicht davon abhängt, dass das Dashboard gesund ist.
Die zwei Stufen, mit echten Zahlen
Jede Abfrage läuft in dieser Reihenfolge, mit dem Schlüssel host/slug:
- L1, im Prozess. Ein ablaufendes LRU mit bis zu 100.000 Link-Datensätzen, jeder für 60 Sekunden. Es nutzt das
expirable-LRU aus hashicorp/golang-lru. Ein Treffer kostet überhaupt kein Netzwerk. - L2, Redis. Ein Cache, den jeder Edge-Prozess gemeinsam nutzt, mit Datensätzen als JSON unter dem Präfix
elido:link:für 5 Minuten. Ein L2-Treffer füllt auch L1 wieder auf. - Origin. Die Link-API über gRPC oder HTTP. Sie ist die einzige Schicht, die sagen darf "diesen Link gibt es nicht". Ein Treffer hier füllt beide Caches.

Zwei Details übersieht man leicht. Erstens wird ein Redis-Fehler exakt wie ein Miss behandelt, sodass ein Redis-Ausfall Redirects verlangsamt, statt sie zu brechen. Zweitens wird eine "nicht gefunden"-Antwort des Origin nicht gecacht. Tippfehler und Scanner, die zufällige Slugs abklopfen, gehen jedes Mal zum Origin. Das ist eine bekannte Lücke, und sie wäre das Erste, was ich beheben würde, falls Probe-Traffic je ins Gewicht fiele.
Gleichzeitige Misses fassen wir heute auch nicht zusammen. Wenn ein kalter Link im selben Moment einen Klickschwall bekommt, kann jeder einzelne den Origin erreichen. Das hat uns nicht geschadet, aber es ist eine Grenze, die Sie kennen sollten, bevor Sie dieses Design kopieren.
Warum L1 nur 60 Sekunden hält
Ein Cache im Prozess lässt sich nicht teilen, jeder Edge-Prozess hält also seine eigene Kopie. Um ihn von außen zu leeren, abonniert jeder Edge-Prozess im Hintergrund einen Redis-Pub/Sub-Kanal und verwirft einen Schlüssel, sobald eine Invalidierungsnachricht eintrifft. Die TTL von 60 Sekunden ist das Sicherheitsnetz dahinter: kurz genug, dass eine verpasste Nachricht schnell heilt, lang genug, dass ein Link mit stetigem Traffic fast immer aus dem Speicher bedient wird.
Dieselbe Überlegung erklärt die Größenbegrenzung. 100.000 Einträge decken eine heiße Arbeitsmenge ab, weil Redirect-Traffic stark schief verteilt ist. Ein kleiner Anteil der Slugs bekommt die meisten Klicks, und der Rest kann zu L2 durchfallen, ohne dass es jemand merkt.
Wenn Sie Ihren eigenen dimensionieren, beginnen Sie mit der TTL. Wählen Sie die Veralterung, die Sie einem Kunden gegenüber vertreten können, und rechnen Sie von dort auf die Trefferquote zurück, die sie Ihnen bringt.
Wie Änderungen den Edge erreichen
Wenn jemand einen Link ändert, wird zuerst Postgres aktualisiert. Direkt nachdem der Schreibvorgang gespeichert ist, löscht api-core den Redis-Schlüssel des Links und veröffentlicht eine Invalidierungsnachricht auf elido:link:invalidate. Jeder Edge-Prozess hört mit und verwirft seine In-Memory-Kopie. Der nächste Klick verfehlt beide Stufen und lädt den neuen Datensatz vom Origin. Besucher sehen die Änderung binnen ein bis zwei Sekunden.
Der Purge deckt mehr ab als das Ziel: Targeting-Regeln, Passwort, Ablaufdatum, Klicklimit, Status, Redirect-Typ, eine Slug-Änderung (alte und neue Kurz-URL werden geleert, sodass die alte sofort nicht mehr aufgelöst wird), Löschungen, Wiederherstellungen aus dem Papierkorb, Statusänderungen in großen Mengen, A/B-Varianten, ein neues Scanner-Urteil, das Anbringen eines CTA-Overlays und das Rotieren der Verschlüsselung. Es gibt keine Einstellung; jeder Plan bekommt ihn.
Eine Race Condition brauchte einen zweiten Durchgang. Eine Abfrage, die kurz vor dem Schreibvorgang begann, kann die alte Zeile lesen und nach dem Purge wieder in Redis ablegen. Deshalb leert api-core 2 Sekunden später noch einmal, was dieses Fenster schließt.
Der Purge ist Best Effort und liegt nie auf dem Redirect-Pfad. Ist Redis kurz nicht erreichbar, übernehmen die TTLs als Fallback, und der schlimmste Fall ist der alte: L2 kann den alten Datensatz bis zu 5 Minuten halten, und ein Edge-Prozess kann ihn kurz vor dem Ablauf von L2 in L1 laden und weitere 60 Sekunden behalten, insgesamt etwa sechs Minuten.
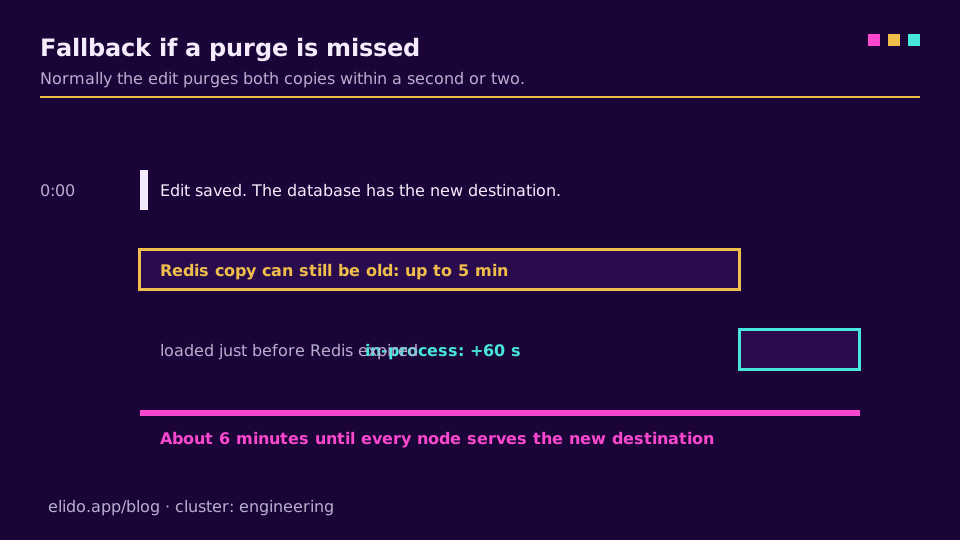
Das ist der Fallback, nicht der Normalweg. Im Normalbetrieb macht der Purge daraus ein bis zwei Sekunden.
Nicht alles wird pro Link geleert. Änderungen auf Workspace-Ebene, etwa Pixel, Branding, Änderungen am Inhalt eines CTA-Overlays und domainweite Einstellungen, folgen weiterhin den normalen TTLs, sofern nicht schon eine Admin-Aktion sie geleert hat.
Für einen Launch oder eine Abschaltung heißt das: Sie können das Ziel genau dann ändern, wenn Sie es brauchen, und es ein paar Sekunden später mit curl -I prüfen. Bevor es den Purge gab, lautete der Rat hier, Änderungen sechs Minuten früher einzuplanen. Das ist nicht mehr nötig.
Cache-Warming und Kaltstarts
Wir wärmen nichts vor. Ein frisches Redis startet leer und füllt sich, wenn Links angeklickt werden. Ein frisch gestarteter Edge-Prozess beginnt mit leerem L1 und fällt für die ersten Anfragen zu Redis durch, dann füllt er sich mit der Nutzung der Links.
Das ist absichtlich langweilig. Weil jede Schicht Best-Effort ist und der Origin maßgeblich, kostet ein kalter Cache Latenz beim ersten Klick pro Link, nie Korrektheit. Wenn man Ihnen sagt, Sie bräuchten einen Pre-Warm-Button, fragen Sie zuerst, wie hoch die Latenz beim kalten Klick tatsächlich ist. Für die meisten Workloads sieht sie niemand.
Der andere Redirect-Cache: Ihr Browser
Die meisten Suchen nach "Redirect-Caching" betreffen einen ganz anderen Cache, und er verursacht mehr Support-Tickets als unserer. Browser cachen Redirect-Antworten, und der Statuscode entscheidet, wie hartnäckig.
Eine 301 ist "permanent". Die HTTP-Caching-Spezifikation (RFC 9111) behandelt sie standardmäßig als cachebar, und Browser haben sie historisch ohne Ablaufdatum gespeichert, wenn kein Header etwas anderes sagt. Rowan Collins' Beitrag beschreibt die klassische Falle: Eine Weiterleitung wird gecacht, die URL wird später wiederverwendet, und Besucher mit der alten Kopie springen endlos hin und her. Eine 302 oder 307 wird nur wiederverwendet, wenn ein Frische-Header es erlaubt. MDNs Caching-Leitfaden ist die klarste Referenz für die beteiligten Header: max-age legt die Frische fest, private beschränkt die Speicherung auf den Browser, und no-store unterbindet das Speichern ganz.
Unsere Redirect-Antworten senden Cache-Control: private, max-age=0, no-store, egal ob der Link 301, 302 oder 307 nutzt. Browser fragen den Edge daher beim nächsten Klick erneut. Das ist ein bewusster Kompromiss. Sie verlieren etwas Tempo bei wiederholten Besuchen und gewinnen zwei Dinge: Jeder Klick wird gezählt, und eine Zieländerung hängt nicht im Browser von jemandem fest. Auch die Zwischenseiten für deaktivierte, abgelaufene oder fehlende Links sind no-store, damit ein wieder lebender Link nicht von einem gecachten Fehler verdeckt wird.
Wenn Sie eigene Weiterleitungen betreiben, wählen Sie den Status bewusst. Unser Leitfaden 301 vs. 302 und die Übersicht der Redirect-Typen zeigen, wann welcher passt.
Eine gecachte Weiterleitung in Chrome löschen
Wenn ein Browser an einer alten 301 hängt, beheben Sie zuerst den Server und leeren Sie dann die Kopie des Browsers:
- Öffnen Sie DevTools und wechseln Sie zum Tab Network.
- Setzen Sie Preserve log und leeren Sie das Protokoll.
- Laden Sie die weiterleitende URL, damit die Redirect-Anfrage erscheint.
- Klicken Sie mit der rechten Maustaste auf diese Anfrage und leeren Sie dafür den Browser-Cache.
Ein normaler Hard Refresh reicht oft nicht. Für einen schnellen Test, ohne Ihr normales Profil anzufassen, laden Sie die URL in einem privaten Fenster oder führen Sie curl -I https://your.short/link aus, um den echten Status und die Header ohne Browser-Cache zu sehen. Wenn Sie mehrere Weiterleitungen verketten, ist ein veralteter gecachter Hop auch eine klassische Ursache für Schleifen. Siehe so beheben Sie eine Redirect-Schleife.
Was jede Entscheidung kostet
Jede Zahl oben ist ein Kompromiss, den Sie verschieben können.
- Erhöhen Sie die L1-TTL, und Sie sparen einige Redis-Lesezugriffe, zum Preis eines längeren veralteten Fensters, wann immer eine Invalidierungsnachricht verpasst wird. Wir fanden dafür wenig Anlass.
- Erhöhen Sie die L2-TTL, und der Origin sieht weniger Traffic, aber ein verpasster Purge braucht länger, bis er heilt. Fünf Minuten waren unser Kompromiss.
- Verzichten Sie auf L2, und jeder Edge-Knoten braucht mehr Origin-Kapazität, da zwischen Prozessen nichts geteilt wird.
- Lassen Sie Browser cachen (301 ohne
no-store), und Sie sparen wiederholten Traffic, verlieren aber genaue Klickzahlen und die Möglichkeit, Ihre Meinung zu ändern.
Ein zweistufiger Cache mit Purge beim Schreiben passt, wenn Lesezugriffe die Schreibzugriffe dominieren, die Schlüsselverteilung schief ist und einige Minuten Veralterung in dem seltenen Fall akzeptabel sind, dass ein Purge verloren geht. Er passt schlecht, wenn sich Ziele oft ändern und sofort wechseln müssen oder wenn jede Anfrage einzigartig ist.
Von außen beobachten
Unsere Cache-Zähler können Sie nicht sehen, aber ihre Wirkung schon. Eine synthetische Probe, die Redirect-Latenz und Status aufzeichnet, zeigt eine langsame erste Anfrage nach einem Deploy und danach flache Latenz. Das Datadog-Dashboard für Redirect-Latenz führt durch dieses Setup, und Fire-and-Forget-Click-Ingestion behandelt, was mit jedem Klick passiert, nachdem der Redirect ausgeliefert wurde.
Wenn Sie gebrandete Kurzlinks auf Ihrer eigenen Domain möchten, bei denen dieses Verhalten für Sie erledigt ist, sind eigene Domains der Einstieg, und die Preisseite zeigt, welcher Tarif wie viele Domains enthält.
Verwandte Beiträge im Blog
- Redirect-Latenzbudget: Wie Elido p95 unter 15 ms anpeilt - der Cornerstone für den Engineering-Cluster.
- 301 vs. 302 Weiterleitungen: Welche sollten Kurzlinks verwenden - welchen Status Sie senden und was er für Browser und Suche bedeutet.
- URL-Weiterleitungstypen: 301, 302, 307, 308 und mehr - die vollständige Liste der 3xx-Codes und wann welcher gilt.
- Redirect-Schleife: So finden und beheben Sie ERR_TOO_MANY_REDIRECTS - gecachte Hops sind ein häufiger Übeltäter.
- Redirect-Ketten und SEO: Wie viele Hops sind zu viele? - was zusätzliche Hops kosten.
- Fire-and-Forget Click-Ingestion: Analytics ohne Hot Path - was mit jedem Klick nach dem Redirect geschieht.
Häufig gestellte Fragen
Cachen Browser 301-Weiterleitungen?
Ja, und zwar aggressiv. Eine 301 ohne Cache-Header ist cachebar, und manche Browser behalten sie ohne Ablaufdatum, sodass der Browser weiter zum alten Ziel springen kann, nachdem Sie es serverseitig geändert haben. Ein Cache-Control-Header mit no-store oder einem kurzen max-age verhindert das.
Werden 302-Weiterleitungen gecacht?
Nicht standardmäßig. Eine 302 ist temporär, daher verwenden Browser sie nur wieder, wenn ein Cache-Control- oder Expires-Header sie als frisch ausweist. Deshalb ist eine 302 die sicherere Wahl, solange Sie eine Weiterleitung noch testen.
Wie lösche ich eine gecachte Weiterleitung in Chrome?
Beheben Sie zuerst den Server, öffnen Sie dann DevTools, wechseln Sie zum Tab Network, setzen Sie Preserve log, laden Sie die weiterleitende URL und leeren Sie den Cache für diese Anfrage. Ein normaler Hard Refresh lässt die gecachte Weiterleitung oft bestehen. Ein privates Fenster ist der schnelle Test.
Wie lang sollte die TTL eines Redirect-Caches sein?
So lang, wie Sie ein veraltetes Ziel tolerieren können, falls ein Purge je ausbleibt. Wir nutzen 60 Sekunden im Prozess und 5 Minuten im gemeinsamen Cache, und jede Änderung leert beide, sodass eine Änderung normalerweise binnen ein bis zwei Sekunden sichtbar ist. Die TTLs sind der Fallback: Schlägt der Purge fehl, kann eine Änderung bis zu etwa sechs Minuten brauchen, bis sie für alle gilt.
Warum führt mein Kurzlink nach der Bearbeitung noch zur alten URL?
Bei Elido leert eine Änderung die Edge-Kopien binnen ein bis zwei Sekunden, danach liegt es meist an Ihrem Browser oder an einer Weiterleitung vor Elido, die eine frühere 301 gespeichert hat. Prüfen Sie mit curl -I die echte Antwort und testen Sie dann in einem privaten Fenster, um den Browser auszuschließen.
Lässt Elido zu, dass Browser seine Weiterleitungen cachen?
Nein. Die Redirect-Antwort trägt Cache-Control private, max-age=0, no-store, auch bei Links, die auf 301 gesetzt sind. Jeder Klick erreicht den Edge, das hält die Klickzahlen ehrlich und erlaubt eine Zieländerung, ohne auf Browser zu warten.
Elido testen
URL einfügen, kurzer Link in Sekunden
Kein Konto nötig. Link bleibt 30 Tage aktiv. Konto erstellen, um ihn dauerhaft zu behalten.
Kostenloses Konto erforderlich. Der Free-Plan enthält insgesamt 25 Links. Du hast schon ein Konto? Anmelden