
ElidoのDub.coインポーターは、DubのREST API経由でリンクを1リクエストあたり100件ずつ読み取り、同じスラッグでElidoの1つのドメイン上に作成します。引き継ぐのは、スラッグ、遷移先URL、タイトル、タグ名です。フォルダー、アーカイブ済みリンク、クリック履歴、リンクの設定は引き継ぎません。移行を計画しているなら、これが重要な事実です。
この記事の以前のバージョンでは、Dubのフォルダーはタグにフラット化されると書いていました。今回の更新でインポーターを読み直したところ、それは誤りでした。コードはフォルダーを一切読みません。このバージョンでは、services/api-core/internal/imports/dub.goが現在行うことを、Dubの公開APIスペック(2026-10-02時点でのアクセス)と照らして確認したうえで説明します。
インポーターがDubに求めるもの
ワーカーは、あなたのキーをベアラートークンとしてGET https://api.dub.co/links?page=N&pageSize=100を送ります。DubのAPIキーのドキュメント(2026-10-02時点でのアクセス)によると、キーは1つのワークスペースに紐づき、読み取り専用で作成できます。ワーカーはリンクを一覧するだけでDubには何も書き込まないため、このインポートに必要なのは読み取り専用のキーだけです。
レスポンスは単純なJSON配列です。「続きがあるか」を示すフラグはないため、ワーカーは100件より短いページまたは空のページが返ってくるまでページを要求し続けます。
if len(links) == 0 { break }
// ... import each link ...
if len(links) < dubPageSize { break } // last page
page++
Dub自身のスペックから1つ注意があります。pageパラメータは、startingAfterによるカーソルページングを推奨して非推奨とされています。現在も動作し、pageSizeは最大100まで受け付けます。Dubがpageを削除した場合、インポーターには小さな変更が必要になりますが、それは黙ってデータが失われるのではなく、明確なHTTPエラーを伴う失敗ジョブとして現れるはずです。
Dubのレート制限のページ(2026-10-02時点でのアクセス)には、Freeプランで毎分60リクエスト、Proで600と記載されています。インポーターはリクエストの合間にPostgresへ1件ずつリンクを挿入するため、実際にはFreeの上限に近づくことはありません。また再試行もありません。HTTP 429やそれ以外の200でない応答は、メッセージにステータスコードを付けて、ジョブを失敗で終わらせます。
Elidoに入るもの(フィールドごと)
| Dubのフィールド | Elidoでの扱い | 備考 |
|---|---|---|
key | スラッグ | 後述の競合戦略に従う |
url | 遷移先URL | URLまたはkeyのないリンクは失敗として数えられる |
title | タイトル | 200文字に切り詰め |
tags[].name | タグ | 名前のみ、色は引き継がれない |
| (なし) | imported:dubタグ | インポートされたすべてのリンクに追加される |
domain、folderId、archived、その他 | 読み取らない | 次の2つのセクションを参照 |
Dubのリンクのそれ以外はすべて捨てられます。説明、ソーシャルプレビュー画像、有効期限、パスワード、地域とデバイスのターゲティング、UTMフィールド、iOSとAndroidのターゲット、コンバージョン追跡のフラグなどです。リンクがこれらのどれかに依存しているなら、インポート後に作り直してください。Elidoにはターゲティング用の独自のスマートリンクのルールがありますが、Dubのルールを自動的に対応づけるものはありません。

フォルダー、アーカイブ済みリンク、ドメイン
Dubの3つの概念は扱われず、それぞれが驚きの元になりえます。
フォルダー。 Dubのリンクスキーマでは、フォルダーはfolderIdの文字列としてしか現れません。インポーターにはそのためのフィールドがなく、フォルダー名を解決する2回目の呼び出しも行いません。Elidoにあるのはフォルダーではなくタグなので、将来のインポーターでもフラット化が必要になるでしょう。現時点では、フォルダー構造は失われます。重要なら、開始前にスラッグごとのフォルダーを記録し、その後、インポートしたまとまり(imported:dubで絞り込み)に手作業またはAPIでタグを付けてください。
アーカイブ済みリンク。 Dubの一覧エンドポイントは、デフォルトでfalseのshowArchivedパラメータを取ります。インポーターはこれを設定しないため、アーカイブ済みリンクは返されず、インポートされません。移行としては妥当なデフォルトですが、古いキャンペーンのリンクを意図的にアーカイブしているなら、知っておく必要があります。
リンクのドメイン。 Dubのワークスペースは複数のドメインにリンクを持てます。インポーターはそのすべてを読み取り、domainフィールドを無視して、あなたが選んだElidoの単一ドメイン上にすべてのリンクを作成します。2つのDubドメインが同じkeyを使っていると、2つ目は競合に当たります。次に何が起きるかは競合戦略が決めるので、それを念頭に選んでください。
競合、上限、ワーカーの契約
ジョブの開始時に競合戦略を選びます。
suffixはmylink-2、mylink-3と-50まで試し、その後そのリンクを諦めて失敗として数えます。skipは既存のElidoのリンクには手を付けず、そのスラッグをスキップとして記録します。failは最初の競合でジョブ全体を止めます。
1回の実行につき、ワーカーは5万リンク(MaxLinksPerImport)または30分(ImportRunBudget)のどちらか早い方で止まります。進捗は50リンクごとに保存され、ダッシュボードがそれをポーリングします。エラーログは最大1,000件を保持します。各スラッグの確認は、(domain_id, slug)に対するインデックス付きの検索1回です。
大規模なアカウントに対するDubのインポートのベンチマークは取っていないため、1分あたりのリンク数は記載しません。ループは100リンクのHTTPページ1つに続いて100件の逐次挿入なので、所要時間はDubの応答の速さとあなたのデータベースで決まります。まず小さなワークスペースでテストしてください。
トークンの扱いとデプロイ時に起きること
キーはPOST /imports/dubのリクエストボディで送られ、実行中のワーカーのメモリに保持されるだけで、保存されることはありません。ジョブ行のsource_token_idは空のままです。ジョブのsource_filter列に入るのは、任意のworkspace_idのテキストだけです。
ワーカーはcontext.WithoutCancelでHTTPリクエストから切り離したgoroutineで動きます。これによりレスポンス後も生き続けますが、同時に、デプロイや再起動で実行の途中で終了させられることも意味します。スケジューラのジョブが5分ごとに動き、30分間進捗のないrunning状態のインポートを失敗としてマークします。再実行は、suffixのもとでも(すでにインポート済みのものは-2のコピーになります)、skipのもとでも(インポート済みのスラッグはスキップされます)安全です。最後のページから再開するものはまだありません。
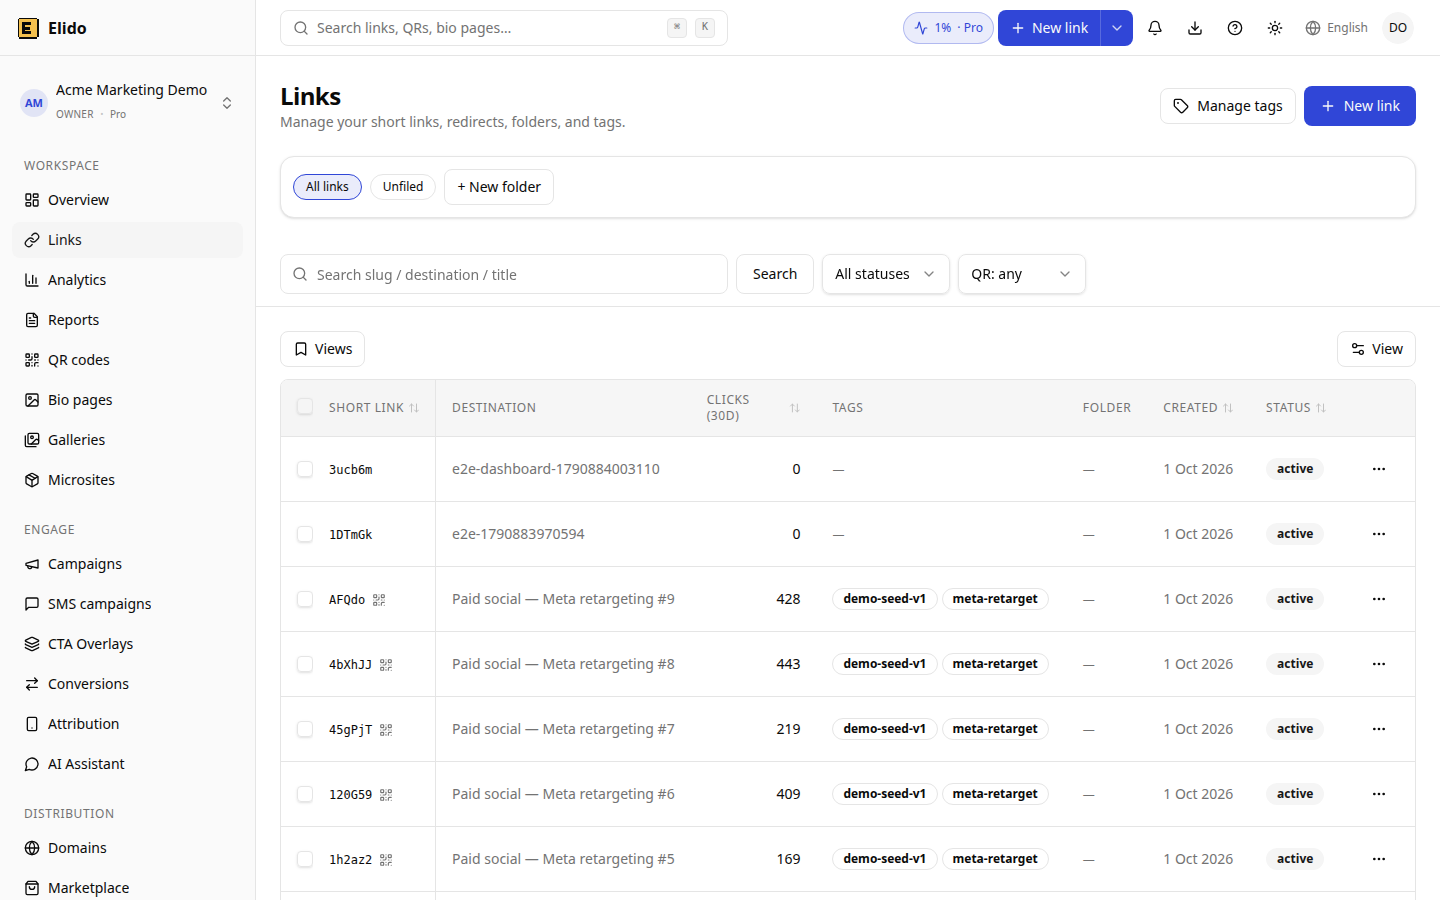
合成データを使ったデモワークスペースのリンク一覧。インポート後は、imported:dubタグで絞り込むとそのまとまりを見つけられます。
実行前の短いチェックリスト
- Dubのワークスペースで読み取り専用のAPIキーを作成します。
- 残したいアーカイブ済みリンクのアーカイブを解除し、頼っているフォルダー構造を書き留めます。
- Elidoにターゲットのドメインを追加し、すべてのDubドメインがこの1つに集約されることを理解したうえで
skipかsuffixを選びます。 - ダッシュボードの連携ページからインポートを実行するか、
token、target_domain_id、conflict_strategyを付けてPOST /imports/dubを呼びます。 - スラッグと遷移先をDubと照らして抜き取り確認し、所有するカスタムドメインのDNSを更新します。DNSの順序は、どのベンダーでも同じで、Bitly切り替えのプレイブックで扱っています。
そもそも移行するかどうかをまだ決めかねているなら、ElidoとDubの比較がプランと機能を比べ、URL短縮サービスのGDPRがデータ常駐の側面を説明しています。ベンダー向けのウォークスルーはDub移行ページにあります。
関連記事
よくある質問
Dub.coインポーターはElidoに何を取り込みますか?
読み取った各リンクについて、インポーターはスラッグ(Dubのkey)、遷移先URL、タイトル(200文字に切り詰め)、タグ名を引き継ぎ、imported:dubタグを追加します。Dubのレコードからそれ以外は読み取りません。説明、有効期限、パスワード、UTMフィールド、ターゲティングルール、クリック数はありません。
Dubのフォルダーはインポート後も残りますか?
いいえ。Dubの一覧エンドポイントは各リンクにfolderIdを返すだけでフォルダー名は返さず、インポーターもフォルダーを参照しません。インポートされたリンクはタグを保持しますが、フォルダー情報なしで届きます。フォルダーに頼っているなら、開始前に、どのタグまたはスラッグのパターンがどのフォルダーに対応するかを書き留めておいてください。
アーカイブ済みのDubリンクはインポートされますか?
デフォルトではされません。Dubの一覧エンドポイントは、showArchivedパラメータが送られない限りアーカイブ済みリンクを除外し、インポーターはそれを送りません。残したいものは、インポートを実行する前にアーカイブを解除するか、手作業で作り直してください。
インポートを1つのDubワークスペースに絞れますか?
DubのAPIキーは1つのワークスペースに属するため、キーが一覧の範囲をすでに制限しています。APIは任意のworkspace_idフィールドを受け付け、Dubへクエリパラメータとして転送しますが、Dubの公開されている一覧パラメータにはそれが含まれません。ダッシュボードのフォームにもそのようなフィールドはないので、何も起こらないものとして扱ってください。
1回の実行で何件のリンクをインポートでき、どのくらい時間がかかりますか?
実行は5万リンクまたは30分のどちらか早い方で止まり、1リクエストあたり100リンクを読み取ります。それを超えると、ジョブは止まった時点で予算超過のメッセージとともに失敗として記録されます。30分間進捗のない実行も、失敗として一掃されます。
インポーターはセルフホストのDubで動きますか?
現時点では動きません。APIのベースはコード内でhttps://api.dub.coに固定されており、変更する設定や環境変数はありません。セルフホストのDubインスタンスをダッシュボードから指定することはできません。自分のデータベースからリンクをエクスポートし、ElidoのAPIで作り直してください。
Elidoを試す
URLを貼り付けて短縮リンクを取得
登録不要。リンクは30日間有効。永久に保存するには登録してください。
Free、登録不要 · 1日あたり2件